你现在攥着的手机,刷半小时短视频就烫得能焐手,电量掉得像漏了的水桶。但你自己的大脑,一边分辨着窗外的鸟叫是什么品种,一边记着下班要取快递,还能顺便咂摸出中午吃的黄焖鸡多放了两勺辣椒——全程加起来的功耗也就20瓦,连你桌上的台灯一半都不到。
真的。
这种离谱的功耗差,就是类脑计算最开始被拎出来的原因。
现在的AI,本质上是在拿蛮力算答案
你现在用的所有电子设备,不管是手机里的大模型,还是跑在数据中心的超算,用的都是沿用了快80年的冯诺依曼结构。说白了就是计算和存储是分家的——就像你做数学题,每算一步,就得跑到另一间屋子去拿草稿纸,算完再跑回去放,来回跑路上耗的能量,比你真正算题花的精力多十倍都不止。
之前看过Nature的公开报道,训练一次千亿参数的大模型,消耗的电量够普通三口之家用一整年。更别说你现在让手机跑个本地的小模型,立刻烫到降频,风扇转得像要飞起来——本质上都是这种“来回跑着拿数据”的结构在浪费能量。
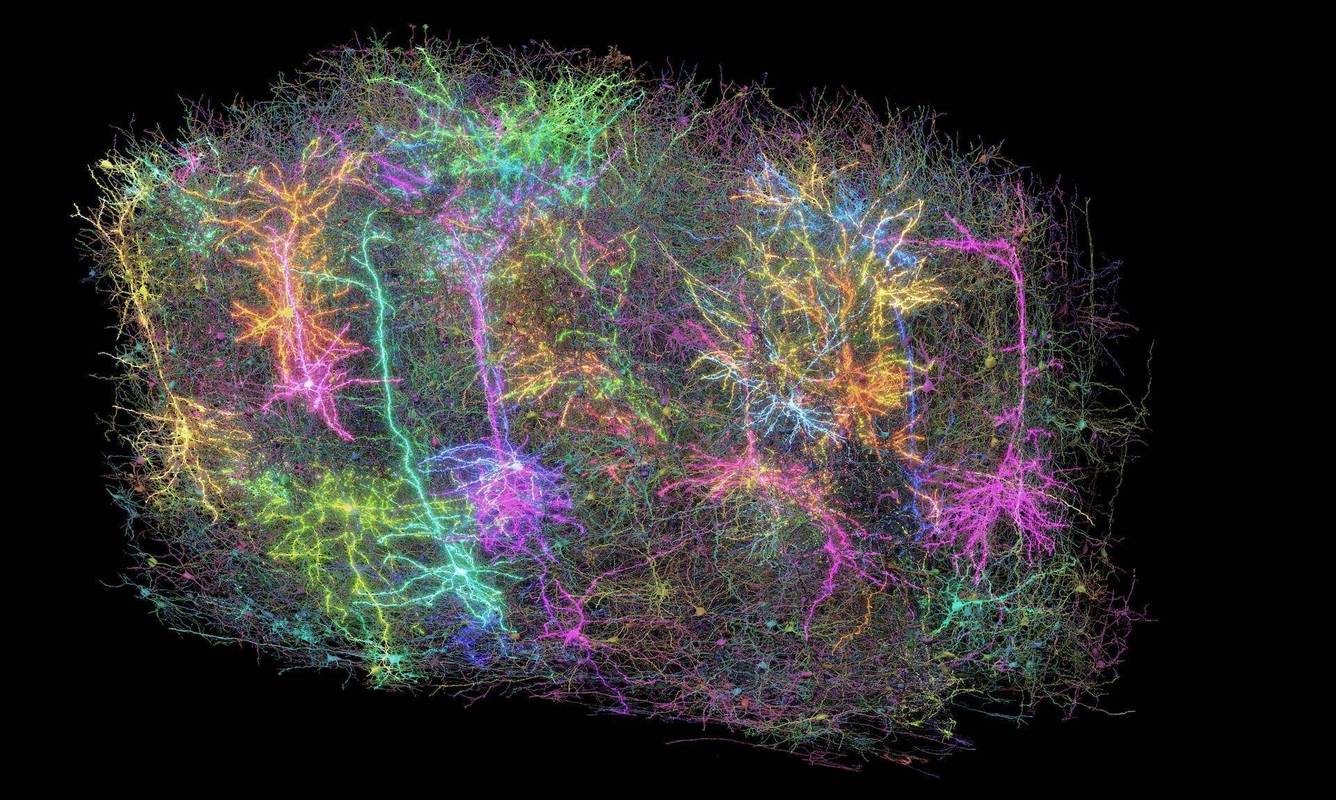
更有意思的是,这种结构算出来的结果,其实根本没有“记忆”的概念。你给它喂一百万张猫的照片,它能认出猫,但你要是把猫的照片倒过来放,它可能就傻了——毕竟它只是在算像素和之前见过的样本有多少重合度,根本不知道“猫”到底是什么。
类脑计算根本不是“做个像大脑的AI”
很多人第一次听类脑计算,第一反应是“哦,就是做个能有自我意识的仿生人脑?”
拉倒吧。差得远。
类脑计算最开始的出发点,根本不是为了做更聪明的AI,是为了把计算和存储合到一块,省点电。
你想啊,人脑里的神经元,就是边存边算的——看到一个熟人的脸,视觉神经元接收到信号,旁边的突触直接就把之前存的记忆调出来了,根本不用跑去找别的地方拿数据。类脑芯片就是照着这个逻辑做的:每一个晶体管模拟一个神经元,旁边连着的电路模拟突触,不用来回跑,就在原地完成计算和存储。
之前浙大公开的达尔文系列类脑芯片测试数据,跑实时动态视觉识别的功耗只有几毫瓦——什么概念?就是靠你走路的时候晃的动能收集器,就能给它供上电,不用插充电器,也不用换电池。
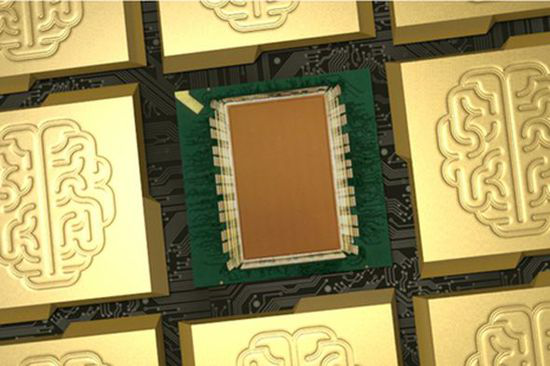
上次去南京紫金山脚下的一个实验室参观,刚好赶上他们测装在野外的红外相机。那种相机要自动识别路过的是野猪还是护林员,以前的传统传感器,要么功耗太高,得每个月爬上去换电池,要么识别不准,拍回来一堆树叶晃的垃圾照片。换成类脑芯片之后,靠太阳能板晒俩小时,就能连续跑大半年,识别准确率还能达到要求。
我当时凑过去看,那个小芯片比我指甲盖还小,旁边的研究员挠头笑,说现在还是有bug——要是护林员穿了迷彩服,它有时候会当成野猪,得反复调参数。
别吹得太神,它现在连“认共享单车”都费劲
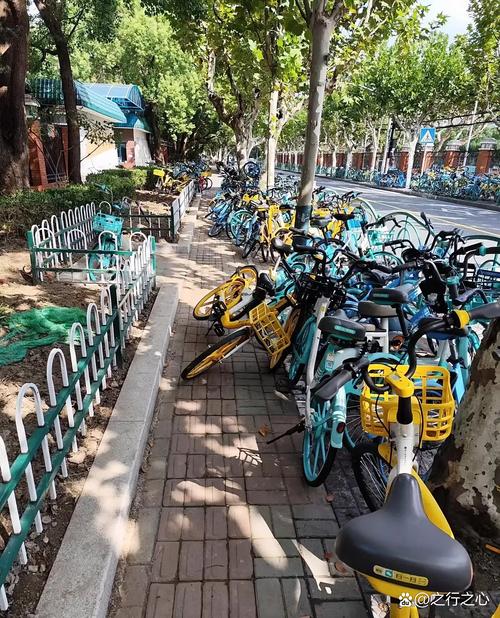
说出来有点好笑。我们现在能在指甲盖大小的面积上,集成上百万个模拟神经元,但是训练它认个路边的共享单车,比你家三岁小孩学得还慢。
问题出在哪?传统的AI是靠反向传播训练的——给它错的结果,它就调整参数,调几百万次总能调对。但类脑的脉冲神经网络,现在还没找到这么高效的训练方法。就像你教小孩认猫,给他看一张照片他下次就能认,但现在的类脑芯片,你得给它反复刺激几十上百次,它才能形成稳定的连接,记住“这是猫”。
更别说现在我们对大脑的理解,本来就半吊子。你想啊,我们连人脑里的突触到底是怎么存长期记忆的,都没完全搞清楚,就敢说自己做的芯片是“类脑”?说白了,现在的类脑计算,就是我们看着大脑的样子,照着葫芦画瓢,画出来的瓢到底能不能装水,还得慢慢试。
不过话说回来,我还是挺期待的。
别听那些媒体吹什么“下一代人工智能革命”,它现在最落地的场景,根本不是什么能聊天的机器人,是那些需要低功耗、长时间在野外跑的东西。比如你家的智能门锁,现在的指纹识别,半年就得换一次电池,要是换成类脑的,可能一颗纽扣电池能用十年。还有那种装在马路上的传感器,能自动识别车流量,不用接电线,靠风能就能供电,自己算什么时候要调红绿灯。
上次从实验室出来,我在紫金山脚下找了个小店喝鸭血粉丝汤,汤里的鸭肝切得厚,烫嘴的时候还在想,等哪天这个类脑芯片真的成熟了,我要给我家猫脖子上装一个——看它每天出门到底去哪浪,不用插电,能用一辈子。
想想还挺美的。
作者|科技
排版|科技
审核|柚子