 大讲堂

2026年春天的那场数仓成本退潮
2024年跟风上了当时最火的实时湖仓架构的那家头部国货美妆,当时的项目复盘报告里写的是”通过星型模型实现用户标签体系的快速迭代,支撑大模型智能推荐的全链路数据供给,预计3年覆盖IT投入”,结果2026年Q1拉出来的实际账单里,光是给大模型客服、个性化推荐、用户留存分析三个业务线供数的算力支出,每个月就达到1180万,相当于直接吃掉了华东区300家线下门店导购的全年基础薪资。
离谱吧?
当时他们的数仓负责人在杭州的一个小圈子饭局上吐槽,说2024年项目上线的时候,大家拍着胸脯说星型模型灵活,随便加个维度就能给大模型喂数据,开发效率比老模型高40%,结果跑了一年多才发现,大模型的查询频率跟原来给人做报表完全不是一个量级——原来一天可能就跑几百次报表查询,现在大模型每秒要跑几万次意图识别、用户标签匹配的查询,那些当初为了省开发时间堆上去的冗余字段,每一次查询都要重新扫一遍,光IO开销就压得整个集群喘不过气。算下来,同样的查询任务,星型模型要扫的冗余数据量是雪花模型的2.7倍。
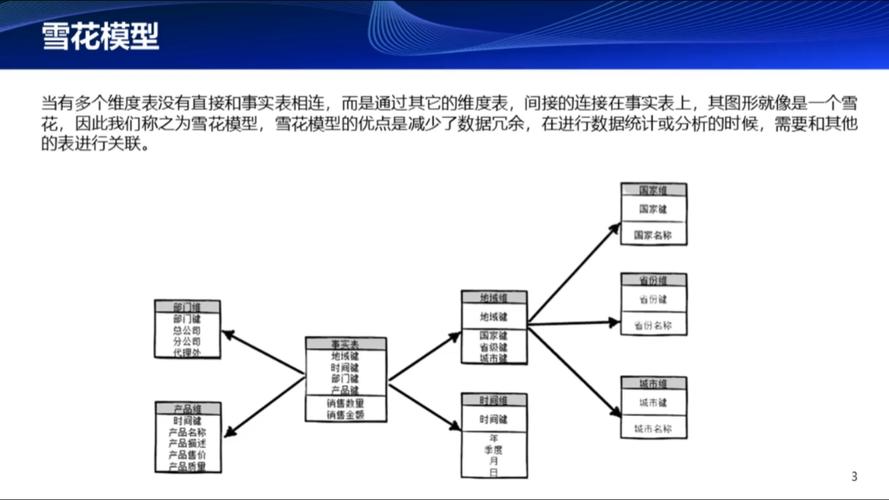
说实话,我当时听到这个数字的时候,差点把手里的冰美式洒在键盘上。三年前整个数仓圈都在吹,星型模型是面向AI时代的最佳架构,谁还在用雪花模型,谁就是跟不上技术潮流的老古董。结果三年不到,大家被账单打回原形,开始偷偷翻出2010年的数仓教材,对着雪花模型的示意图研究怎么拆表。
被骂了10年“太死板”的模型,到底卡了谁的脖子
很多刚入行的小朋友可能不知道,雪花模型在数仓圈被嫌弃了足足10年。原因特别简单:它太麻烦了。要把所有维度都拆到最细,拆成一张又一张的关联表,写个查询SQL要拉四五张表做join,开发效率低,出了问题排查也麻烦。而星型模型就讨喜多了,把所有维度的冗余字段都堆在事实表旁边,写个查询不用做多少关联,半天就能搭好一个用户标签体系,刚好契合互联网公司”快速试错、小步快跑”的调性。
不过话说回来,之前大家不爱用,本质上不是雪花模型不好,是之前的业务场景根本撑不起它的优势。那时候的数仓是给谁用的?是给运营、产品做报表用的,一天查不了几次,冗余点字段根本无所谓,哪怕多存点重复数据,存储成本也没多少钱。可现在的场景变了。当大模型要把全量的用户标签、商品属性、订单数据都拉去做关联计算的时候,每多存一个冗余字段,就意味着每一次查询都要多扫一遍数据,这个成本是指数级上升的。
我去年跟阿里云MaxCompute团队的一个资深架构师吃饭,他说2023年的时候,他们给客户做数仓方案,首推的就是星型模型,说能帮客户省30%的开发时间。结果2025年下半年开始,他们的客户里只要是做大模型相关业务的,全在反过来找他们做模型重构。有个做本地生活的客户,把原来的星型模型全部拆成雪花结构之后,大模型做用户意图识别的查询延迟降了62%,存储成本砍了41%,原来要配3个大模型推理节点才能扛住的并发,现在1个就够了。算下来的投入产出比,相当于你花1万块把家里乱缠的老电线重新理一遍,之后每个月能省3000块电费,而且电器还不容易烧。
这整个行业的技术选型逻辑,就像生物进化里的适者生存——从来不是最先进、最复杂的物种能笑到最后,而是在环境变化后,能耗最低、冗余最少的个体,才能扛过小行星撞地球的冲击。之前那些堆得满满当当的星型模型,就像长着巨大犄角的三角龙,在水草丰美的时代能占尽优势,等到算力账单的寒冬来了,自然拼不过身形小巧、能耗极低的哺乳动物。
不过话说回来,那些卖湖仓解决方案的厂商,之前为什么拼了命推星型模型?道理太简单了——星型模型冗余多,要跑同样的查询就得买更多算力,客户买的算力包越多,厂商赚的就越多。你要是上来就给客户推个能把算力砍一半的雪花模型,那不是砸自己的营收基本盘吗?我个人对那种抱着”技术鄙视链”不放的人,向来没什么好感。总觉得会搭最复杂的架构、用最新的开源项目,就是比用老技术的人高人一等,结果算完账才发现,自己花了几百万搭的系统,还不如别人花几十万用老模型跑的稳、跑的省。
别再追新了,算账才是普通人的生存底线
我认识个在杭州做数仓开发的小伙子,2024年的时候靠给公司搭了一套实时湖仓架构,拿了15万的年终奖,当时他在朋友圈晒奖杯,说自己是公司里最懂AI时代数仓的专家。结果2025年公司开始降本,把他搭的那个实时集群的规模直接砍了70%,他本来以为自己要被优化,结果发现整个部门现在最缺的,就是能把原来的星型模型拆成雪花结构、把冗余字段删干净的人。
这个活难吗?一点都不难。不需要你会写多么高深的分布式算法,不需要你对接最前沿的开源向量数据库,就是要你细心,要懂业务,要算得清楚每一个字段的存储成本、每一次查询的IO开销。但就是这么个不酷的活,现在成了公司里最有价值的事。
之前很多从业者焦虑,说大模型要把数仓工程师取代了。其实根本不是那回事。大模型能帮你写SQL,能帮你搭集群,但是它算不清楚哪个维度拆了之后能省多少钱,哪个关联逻辑会让查询慢3秒,哪个冗余字段是根本没人用的垃圾数据。技术选型的核心从来不是新旧,是成本匹配度——这句话我跟身边的朋友说了不下十次。
说真的,我现在特别烦那种一上来就给你推百万级架构的讲师,好像小公司不配用正经技术似的。我见过太多创业公司,刚拿到融资就上来搞什么实时数仓、向量数据库大集群,结果跑了半年发现,光电费都付不起,最后还是要回来拆冗余,用雪花模型的老方法把数据理干净。
之前那些做数仓培训的机构,2024年的时候课程内容全是教你怎么搭湖仓平台,怎么对接大模型数据接口,结果2026年开始,他们的课程报名量掉了一半,反而那些讲怎么用雪花模型做成本优化的课,场场爆满。大家终于反应过来了,技术不是用来炫的,是用来解决问题的。
上次跟那个算出来千万级账单的数仓负责人吃饭,他说现在团队的KPI已经从”上线了多少新架构”改成”每个月省了多少真金白银”。那你猜,你们公司的下一轮优化名单上,会不会就站着那些只会追新技术、从来不肯低头算一笔明白账的人?
作者|大讲堂
排版|大讲堂
审核|小北