 大讲堂

一个反直觉的现场:技术越成熟,人越贵
2024年夏天,我在上海旁听了一场小型行业闭门会。台上有个做动捕方案的技术负责人,讲完自家产品后,台下第一个举手提问的,不是问延迟多少毫秒,也不是问面捕精度。有人直接问:你们这套方案,能不能让一个中之人同时驱动三个虚拟主播? 全场安静了两秒。然后笑了。 那笑声里有点复杂。技术方想证明自己牛,运营方想压低成本,但真正在一线带过主播的人都知道——问题根本不在这。你让同一个人套三张皮,粉丝第一个月可能看不出来,第三个月一定出事。不是技术穿帮,是“魂”对不上。 虚拟主播这个行当,走到今天,出现了一个非常拧巴的局面:底层技术越来越像自来水,拧开就有;但真正稀缺的,反而是那个坐在动捕设备后面、会累会哭会摆烂的真人。 这跟我们五年前的预判,几乎是反着来的。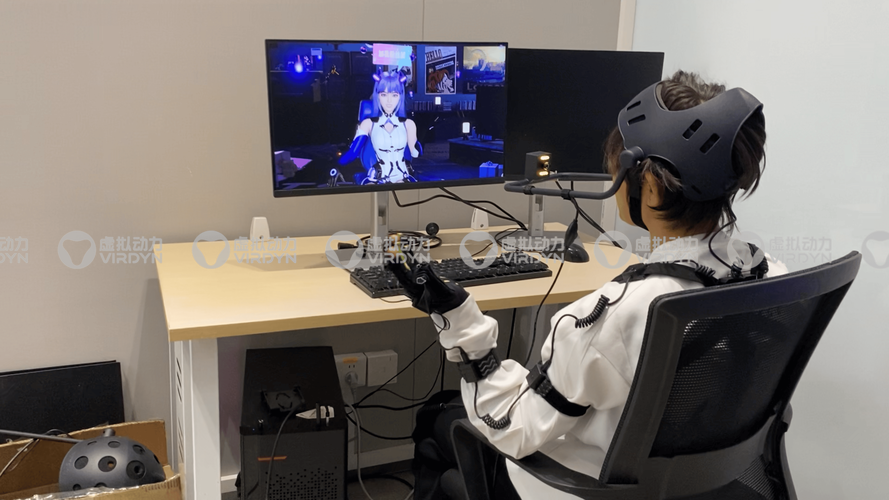
技术边界:面捕已经够用,但“够用”是个危险的词
先厘清一个基本盘。虚拟主播的技术栈,大致分四层:形象资产(Live2D或3D模型)、驱动方案(面捕+动捕)、渲染推流、以及互动层。 过去三年,变化最大的是驱动方案。iPhone的ARKit面捕,配合VTube Studio这类软件,几乎把入门门槛砍到了零。一个大学宿舍里的学生,一台手机,一张Live2D模型,就能开播。这在2019年是不可想象的——那时候你得有一套光学动捕,或者至少十几个惯性传感器绑在身上,场地、校准、维护,全是成本。 但“够用”这个词,在内容行业里是个陷阱。 面捕精度够了,意味着所有中低端虚拟主播的视觉表现趋于同质化。观众看多了,阈值就上去了。真正拉开差距的,反而回到了最原始的东西:声音的辨识度、临场反应的节奏、以及那种“这个人真的在跟我说话”的微妙错觉。 技术解决的是“像不像人”,但观众要的是“是不是这个人”。这是两码事。 目前的技术瓶颈也很具体。3D模型的表情绑定,依旧依赖大量手工权重调整。一个精细的3D皮套,从建模到绑定到调试,两三个月是常态。而Live2D虽然快,但视角受限,做不了大幅度肢体动作。更麻烦的是多人同框的实时渲染——几个3D虚拟主播同台互动时,光影一致性、物理碰撞、口型同步,全是坑。 所以你看,技术不是万能药。它把下限拉高了,但上限那块天花板,还是得靠人来顶。产业链的暗涌:谁在赚钱,谁在焦虑
虚拟主播的产业链,粗略拆开,大概是:工具层(软件+硬件)、内容层(企划+中之人)、平台层(B站、YouTube、抖音)、以及变现层(直播打赏、周边、广告、演出)。 最热闹的是内容层,最不稳定的也是内容层。 日本那边,ANYCOLOR和Cover两家头部企划,市值和营收在过去两年经历了过山车。2023年到2024年,头部虚拟主播的毕业(引退)频率明显加快。原因不复杂:中之人长期高强度直播带来的身心消耗,以及分成结构下日益尖锐的利益矛盾。 国内的情况更碎片化。B站依旧是主阵地,但抖音的虚拟主播生态在悄悄起量。区别在于,B站的用户更愿意为“人设”和“陪伴感”付费,抖音的算法逻辑更偏向短平快的爆点内容。结果就是,同一套皮,在两个平台上的运营策略几乎是分裂的。 有个做企划的朋友跟我吐槽:他们旗下有个主播,在B站是温柔大姐姐,在抖音得剪成搞笑吐槽役。中之人本身没变,但“魂”的切面被平台逻辑硬生生撕开了。 这还不是最要命的。最要命的是,工具层正在试图绕过内容层。 几家做AI驱动方案的公司,近一年都在推“AI中之人”的概念。逻辑很简单:用大模型驱动对话,用TTS合成声音,用预训练的动捕数据生成动作。一套下来,理论上可以7×24小时直播,永不毕业,永不塌房。 听起来很美好对吧?
治理与伦理:皮套下面的那个人,法律还没追上
这是个很少被认真讨论,但迟早要爆的雷。 虚拟主播的法律身份,目前处于一个非常暧昧的地带。皮套的著作权归谁?中之人的声音权、表演权怎么界定?如果中之人跳槽,皮套能不能带走?粉丝打赏的钱,到底是给皮套的,还是给那个声音的? 这些问题,在日本和国内都已经出现过纠纷。有些和解了,有些对簿公堂,但判例之间缺乏一致性。行业跑得太快,法律只能在后头追。 更棘手的是中之人权益。虚拟主播的“永不塌房”是个幻觉。中之人会生病、会抑郁、会因为合约问题被雪藏。而粉丝往往只看到皮套在直播,看不到背后的那个人可能已经连续工作三十天没休息。 有个细节我一直记得。某位毕业的虚拟主播,在最后一场直播里说了一句话:“我终于可以不用笑着说话了。” 这句话在粉丝社区里传了很久。它戳破了一个行业共识:虚拟主播的“虚拟”,保护不了任何人。它只是把真实的痛苦,藏到了一张不会疲倦的皮后面。 未来三到五年,监管大概率会从两个方向切入:一是虚拟形象的知识产权归属,二是直播用工关系的认定。后者尤其关键——中之人算不算“劳动者”?如果是,那工时、社保、解约赔偿,全都要重新谈。未来3—5年判断:三件事会同时发生

作者|fawen
排版|fawen
审核|知知