 大讲堂

他们去年上线的大模型风控系统,比原来的传统评分卡坏账率低了27%,本来是个能拿年度优秀项目的成绩,结果被监管的一次现场检查打懵了。
检查人员随手抽了30笔被拒贷的客户案例,要求每笔都列清楚核心的决策影响因子。整个团队对着满屏的注意力权重界面坐了一下午,愣是没凑出能拿出手的答案。
这就是现在全行业绕不开的坎:金融大模型的准确率卷到天花板之后,多因子风控归因已经从一个技术细节,变成了决定大模型能不能在金融场景真正落地的核心门槛。
被监管追着要的“解释权”,到底卡在哪
传统的多因子风控逻辑其实简单得很。不管是FICO评分卡还是国内银行用了十几年的内部评级体系,每个决策因子的权重都是业务专家拍板定的:征信逾期占35%,收入稳定性占25%,负债收入比占20%,剩下的是居住时长、职业稳定性、历史还款记录这些维度。每笔审批的理由一拉清单就出来,监管要啥给啥,客户问起来也能说的明明白白。
大模型上来之后,一切都变了。
为了追那几个点的坏账率下降,团队把能拿到的数据全喂给了模型:不光是结构化的征信、收入、负债数据,还有非结构化的APP操作路径、申请表填写的停顿时长、客服通话里的语气波动、设备的传感器数据……几百上千个维度堆进去,模型自己学出来的决策逻辑,连训模型的工程师都摸不透。
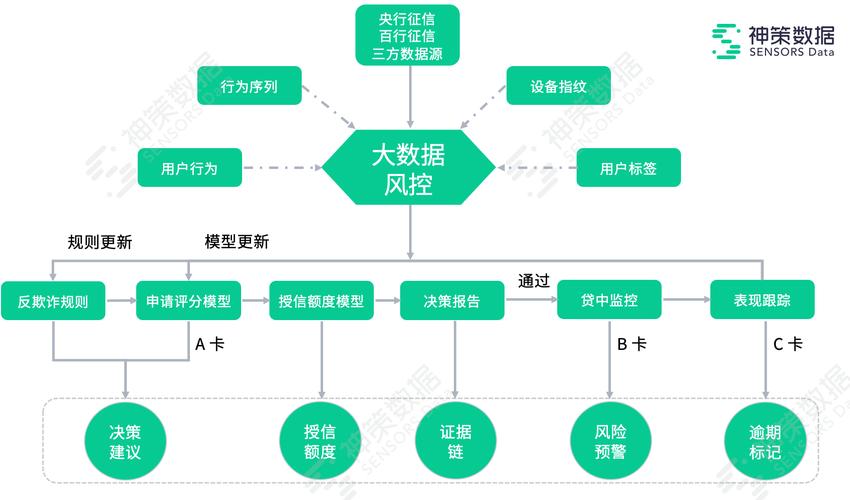
之前行业里也不是没想过办法。最开始大家把普通机器学习模型用的归因工具搬过来,比如SHAP值、LIME,结果放到千亿参数的大模型上直接水土不服。算一笔决策的归因结果要花几十秒,一天几十万笔审批量,光归因计算就能把服务器跑满。更离谱的是,很多时候算出来的结果完全反常识:一个客户明明是因为近3个月信用卡连续逾期被拒,模型算出来的最高权重因子居然是“客户填申请表的时候用的是安卓手机”。
说实话,这种结果拿给监管看,纯粹是找骂。
多因子风控归因的技术边界,根本不是“算得准”这么简单
很多人对金融大模型的多因子归因有个误解,觉得这就是个事后给决策找补理由的工具。实际上现在行业里已经摸出了两条完全不同的技术路径:一条是大家最熟悉的事后归因,就是模型先跑完审批流程出结果,再倒推每个因子对最终决策的贡献度;另一条是内嵌式归因,在大模型的架构里专门留一层因子贡献度校准模块,每一次注意力计算的时候,就把每个输入因子的权重实时记录下来,根本不用事后倒推。
这两种路径的差别,说穿了就是“真解释”和“假解释”的区别。
事后归因的问题刚才已经提过了,计算慢、结果飘,还经常出反常识的结论。内嵌式归因就不一样,因为贡献度是在模型推理过程中实时生成的,计算延迟几乎跟模型推理本身的耗时差不多,某头部互联网消金平台去年上线的系统显示,内嵌归因层之后,单比决策的归因计算耗时只增加了8毫秒,跟原来的推理速度几乎没差,而且归因结果跟业务专家的经验匹配度从之前的不到30%升到了89%。
当然,这里也有明确的技术边界:你不能为了追求可解释性,把模型本身的决策能力打下来。之前有机构为了做归因,把大模型的架构砍成了浅层次的树模型,结果上线之后坏账率比传统评分卡还高30%,折腾了半年最后又切回了老系统,白白浪费了几百万的项目预算。
现在行业里还有个歪风邪气必须吐槽。很多供应商跟客户吹自己的大模型风控“全链路可解释”,结果拿过来一看,就是在黑箱模型外面套了个传统评分卡的壳——大模型先出个审批结果,系统自动从预设的理由库里挑个最像的话术,比如“您的征信记录存在逾期”“您的收入稳定性不足”,根本不管模型实际是因为啥做出的决策。说白了就是贴标签式的假归因,真遇到客户投诉说“我从来没逾期为啥拒我”,一掰就碎。
现在的落地现状,离“真能用”还差三个坎
从2023年下半年开始,整个行业的风向已经变了。之前大家卷的是“谁的模型坏账率低”,现在卷的是“谁的模型决策能过监管的合规检查,谁的归因能真的给业务赋能”。毕竟现在监管的要求摆得很明白:所有自动化的风控决策,必须能给客户提供具体的、可申诉的影响因子,不能拿“系统综合评估不通过”这种废话搪塞人。
这种风向的变化,已经在倒逼整个产业链调整。原来堆参数的大模型厂商,现在要专门拉一支团队做归因模块的开发;原来卖传统评分卡系统的供应商,现在要花精力对接大模型的接口,把归因结果嵌到从审批到贷后管理的全流程里;连卖征信数据的供应商,之前是把打包好的报告往外卖就行,现在得把每个数据因子的来源、计算逻辑拆得明明白白——你连“客户近6个月硬查询次数”这个数是从哪来的都不知道,算出来的归因结果谁敢用?
但就算是这样,离真正的“能用”还差三个实打实的坎:
第一个坎,非结构化因子的归因难。之前的归因都是针对结构化数据,比如收入、负债、逾期这些,好拆权重。但现在大模型用的很多非结构化数据,比如客户在APP里填申请表的停顿时长、客服通话里的语气波动,这些因子怎么算贡献度?比如客户在填工作单位的时候犹豫了10秒,这个行为到底是因为他真的没想好,还是因为他在编造信息?要把这个行为的决策贡献说清楚,根本不是简单算个权重就能解决的。
第二个坎,归因结果的稳定性。同一个客户,隔10分钟申请一次贷款,要是第一次的归因结果是“负债比过高”,第二次是“征信查询太多”,客户肯定要炸,监管也绝对不答应。现在很多大模型的归因结果是飘的,因为模型推理本身带有随机性,你要把这个随机性消掉,让同样的输入永远得到同样的归因结果,技术难度根本不比从头训一个大模型低。
第三个坎,跨场景的归因适配。同一个风控模型,用来做消费贷审批的时候,因子权重是一套;用来做信用卡额度调整的时候,又是另一套。你不能把消费贷的归因逻辑直接套到额度调整上,不然就会出现“客户本来因为长期按时还款应该提额,结果模型算出来的归因是‘客户最近消费太少,有套现风险’”这种离谱的结果。
别把归因做成“甩锅工具”
很多机构现在对归因的理解从根上就错了。他们觉得归因就是为了应付监管检查,应付客户投诉,根本没想过归因本身能给业务带来啥价值。
举个很真实的例子。某城商行去年上线大模型风控之后,发现刚毕业的年轻客群的拒贷率比老模型高了40%。一开始团队以为是年轻客群的信用记录太薄,模型识别不准。结果拉了归因结果才发现,原来训练数据里的“居住稳定性”因子,全是从有房贷的30岁以上客户的样本里学出来的——租房子的年轻客户,在这个因子上天然得分低,模型根本不管你是不是真的有稳定还款能力,直接就给拒了。这种系统性的偏见,你不做深度的归因分析,根本发现不了。最后吃亏的是自己,把最有增长潜力的年轻客群全挡在门外,业务越做越窄。
还有更扯的。很多机构现在开业务复盘会,全是甩锅:业务部门说坏账率高是模型选的因子不对,技术部门说模型没问题是数据不准,数据部门说数据没问题是渠道引入的客户质量差。要是能把每个因子对坏账的贡献度算得明明白白,哪来这么多扯皮?比如某段时间坏账率升了2个点,一拉归因发现是“第三方渠道客户的设备指纹因子”贡献了1.5个点的坏账,直接去查渠道的问题就行,根本不用来回踢皮球。
聊点实在的判断吧,未来3到5年,这个赛道的变化肯定会比大家想的快。
首先,那种事后补解释的“贴标签式归因”肯定会被淘汰。未来的大模型风控系统,内嵌式归因会像现在评分卡的权重一样,是架构天生带的,不是后加的插件。其次,监管肯定会出台明确的行业标准,比如归因结果的透明度要到什么程度,哪些敏感因子(比如性别、地域、民族)是绝对不能用来做风控决策的,客户对归因结果的申诉流程要怎么设计,这些都会有明确的规则。最后,现在那些只会堆参数、吹规模的大模型厂商,大部分会被淘汰,最后能在金融场景活下来的,一定是那些能把模型准确率、合规性、可解释性三者做到平衡的玩家。
上周跟老周再通电话的时候,他说他们行现在新上的归因系统,每次给拒贷客户发的短信,都会列出来三个最核心的影响因子,上线两个月,针对拒贷的客户投诉量直接掉了40%。
你看,哪有什么难到上天的技术?
说白了就是之前大家都太急,光想着把模型准确率拉上去赚快钱,忘了金融这行本来就是做信任的生意——你连自己为啥拒了客户都说不清楚,谁信你能管好风险啊。
作者|大讲堂
排版|大讲堂
审核|乐乐