2026-10-19 21:39:48 作者:大讲堂
2026年开年那会,我跟某股份制银行数据中心的主任吃了顿火锅。
他喝了半瓶啤酒开始吐槽。去年行里花6800万上了整套数据编织平台,接了从核心信贷到零售客群的21个业务系统,当时销售拍着胸脯说“以后找数秒出”。结果到上个月给监管报小微企业授信余额,数错了三个字段,前后跟系统值差了1.2亿,直接被罚了200万。
他说现在团队12个数据分析师,每天到公司第一件事不是做分析,是挨个翻系统找哪个字段的口径变了。上次找个跟消费贷相关的客群标签,前后翻了17个数据字典,花了整整6个小时。
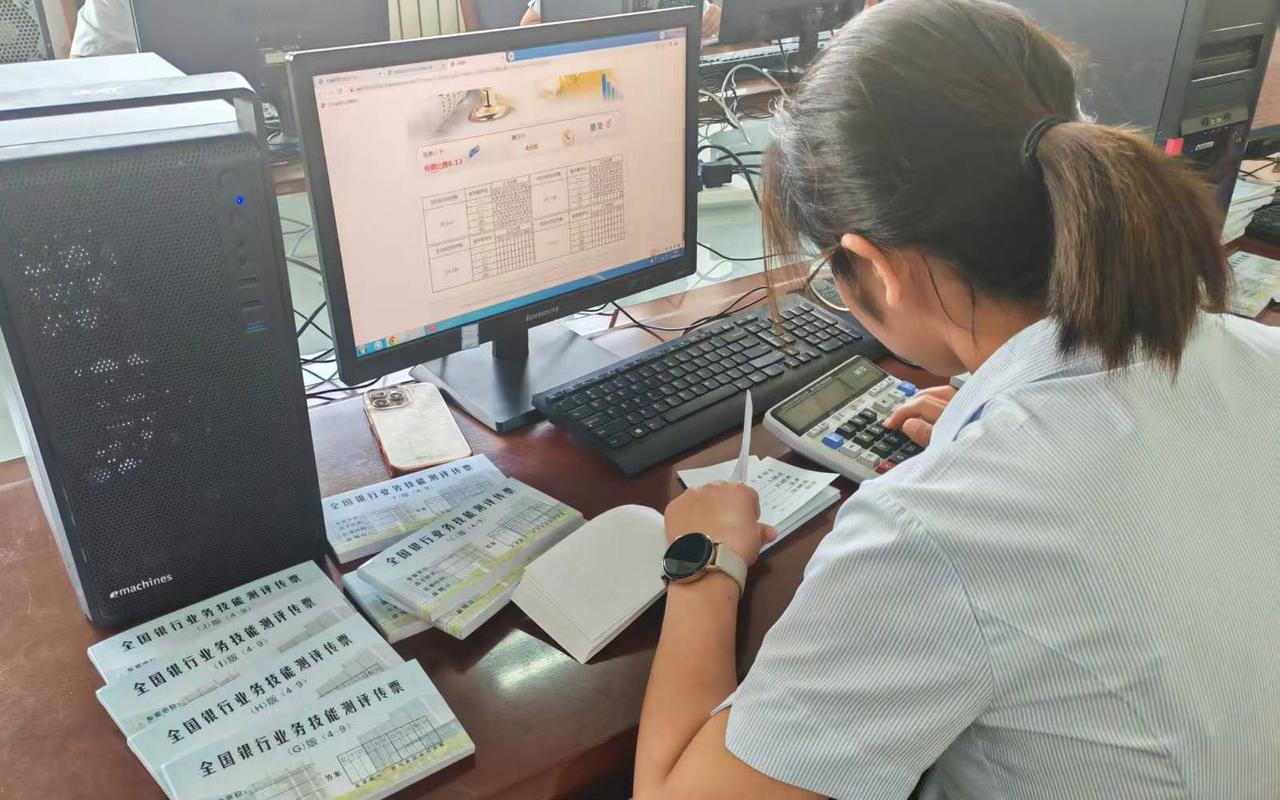 2026年银行数据团队加班找数据场景实拍
2026年的数据团队,正在为过去10年的“数据垃圾债”买单
 2026年的数据团队,正在为过去10年的“数据垃圾债”买单
没人算过这笔账。
很多企业在2022到2024年跟风上的数据中台、数据编织项目,本质上就是把各个业务系统里的零散数据,像捡破烂一样堆到一个统一的存储池里,既没有做口径统一,也没有做权限梳理,甚至连哪个字段是哪个业务线在用都搞不清楚,美其名曰“数据资产化”。
说穿了,这时候的元数据管理还是被动逻辑——等平台把数据爬完了,再事后整理个数据台账,记下来字段叫啥、存在哪个服务器上就完事了。这种被动元数据就是事后记账的糊涂账,既不知道这个字段是哪天被哪个业务岗改的,也不知道最近三个月有没有人真的在用,更别说提前预警哪个字段的口径跟别的系统冲突了。
那个银行的6800万花得有多冤?算下来相当于花了比买3台顶配特斯拉Model S Plaid还贵的成本,把家里散落的17个旧家电全接进了一个号称“全屋智能”的中控系统,结果想找冰箱的实时温度,还要挨个翻每个家电的原始说明书。据某第三方咨询机构2026年初的调研,国内大中型企业在数据管理上的投入,平均有63%是消耗在“跨系统找数、口径对账、错误数据回溯”的无效环节,这部分钱算下来,相当于每家企业每年要白扔出去2.7个核心数据分析师的全年工资。
真的,这哪里是企业数字化的问题?就是过去十年攒下的“数据垃圾债”到了集中兑付的时候。之前大家都觉得把数存下来就算数字化了,没人管这些数能不能用、好不好用,等真要拿数做决策、给监管报数的时候,才发现之前攒的根本不是资产,是一堆没贴标签的旧报纸。
真正的技术拐点,是把元数据管理从“事后”拉到“事前”
我之前跟杭州一家做连锁商超数字化的厂商聊,叫云栖数智。他们2024年的时候跟同行卷得也凶,别的厂商接多少个数据源,他们就接多少,前前后后把ERP、POS、会员系统、供应链的127个接口全接进了数据编织平台,算下来每个月光接口运维费就18万。
结果到年底算ROI的时候,老板发现不对——整个平台一年创造的价值,还覆盖不了接口的运维成本。
后来他们干脆换了思路,不卷接口数量了,转头扎进去做主动元数据管理。啥叫主动?主动元数据的核心是把管理动作前置到数据产生的那一刻——不是等数据爬到平台上了再整理台账,而是在业务系统里录入一个新字段的时候,就自动把这个字段的归属部门、修改权限、调用规则、预警阈值全嵌进去。比如门店录的“临期商品折扣率”字段,系统自动就会标清楚:这个字段是门店运营岗录入的,仓储部有权查看,财务部如果要引用这个字段算报表,必须走口径确认流程,要是折扣率超过70%,自动触发供应链的库存预警。
换了这套逻辑之后,他们平台上的找数时间从之前的平均4.2小时/次,降到了11分钟/次,全年光减少的无效人力成本就有210万。这笔钱如果换成一线员工的餐饮补贴,足够给公司327名在门店和仓储一线的员工,连续发14个月的免费工作餐。
 主动元数据全链路追踪流程示意图
不过话说回来,为啥之前那么多厂商不愿意做主动元数据?
账算得太明白了。被动元数据是卖完平台之后,每年收接口维护费、版本升级费,客户每年都要掏钱,躺赚。主动元数据不一样,需要跟每个业务系统做深度的逻辑绑定,甚至要跟着业务流程的变化随时调整元数据的规则,是个需要沉下去干活的苦差事。而且客户一旦把元数据的规则理顺了,后续的平台运维成本会大幅下降,厂商每年能收的服务费反而会变少。
说白了,这根本不是技术能力的问题,是商业模式的问题。之前的厂商巴不得客户的系统永远乱下去,这样才能永远收“整理数据”的服务费。
普通数据分析师,才是这场技术迭代里最直接的受益者
 普通数据分析师,才是这场技术迭代里最直接的受益者
我认识个在快消行业做了8年的数据分析师,之前跟我吐槽,说最崩溃的事不是熬大夜做分析,是熬了三个通宵做出来的销售预测报告,被业务方一句“你这个数跟我们系统里的对不上”直接打回来。
他说之前有次做华东区的新品销售分析,三个系统里的“新品销售额”口径都不一样:一个把退换货的金额算进去了,一个只算线下门店的数,还有一个把线上旗舰店的数排除在外了。他跟三个业务线的负责人对了整整两天口径,才把数对齐,等报告改完,新品的促销活动都结束了。
之前的数据管理成本,有60%以上是花在“找数、对数、改数”的无效循环里,而主动元数据管理落地之后,这种破事能少80%。分析师打开平台,直接能看到每个字段的全链路:这个口径是2025年11月由华东区运营部定的,最近一次修改是3月12日,之前被12个分析报告引用过,没有口径冲突,甚至能看到之前的分析师是怎么把这个字段跟库存数据关联做分析的。
没人再需要当“数据侦探”,挨个翻旧系统的历史记录找口径。真的,这才是技术本来该有的样子——不是给企业堆一堆看不懂的技术名词,是把人从无意义的重复劳动里拽出来。
很多吹这个赛道的人,张口就是万亿市场、下一代数据基础设施,说穿了都是为了卖概念。数据编织主动元数据管理哪里有那么玄乎?它就是给企业的所有数据装了个带溯源功能的快递柜,每个包裹从哪来、要到哪去、谁拆过,全记的明明白白,再也不会出现快递丢了、找不到人负责的破事。
等再过两年,当所有企业都发现,花几千万堆出来的数据平台,还不如把每个字段的来龙去脉理清楚省的钱多的时候,那些之前靠卖概念赚快钱的厂商,还能靠什么留住客户?
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:数据编织主动元数据管理:卷不动平台堆料,是没人愿意算的隐形成本账
文章链接:https://www.lfdjt.com/info_23_27023.html
 大讲堂
