 大讲堂

上周和长三角某Biotech公司的计算化学负责人在园区咖啡馆碰面,对方刚熬了两个通宵,眼睛红得像兔子。
吐槽的核心不是模型不准。
是算出来的蛋白-小分子结合能,和湿实验测出来的IC50差了两个数量级。
最后翻遍了输入文件才发现——整个团队用了三年的泛函,从来没加过针对蛋白空腔的色散修正项。
两百万的算力集群,跑了上万个筛选分子,白搭。
泛函修正到底在修什么?
很多人对密度泛函的认知,还停留在“把复杂的多电子问题简化成单电子方程”的教科书描述上。
Hohenberg-Kohn定理本身是严格的。
但定理里提到的“交换关联泛函”,从提出到现在快60年了,没人能写出它的精确表达式。
这就是所有问题的根源。
你用的所有泛函,本质上都是对这个未知函数的近似。近似的偏差,就要靠“修正”来补。
从最早的局域密度近似(LDA),到后来的广义梯度近似(GGA),再到杂化泛函、meta-GGA,每一层泛函的升级,本质上都是在缩小和真实交换关联能的偏差。但没有任何一个泛函是万能的——算共价键的结构准,不代表算范德华作用准;算主族元素的反应能准,不代表算过渡金属的强关联体系准。
这时候修正项就上场了。
最常见的是色散修正(比如DFT-D3、D4),用来补泛函对弱相互作用的描述缺陷;然后是Hubbard U修正,用来补过渡金属d轨道的强关联偏差;还有长程修正、相对论修正,针对不同的极端体系补精度。
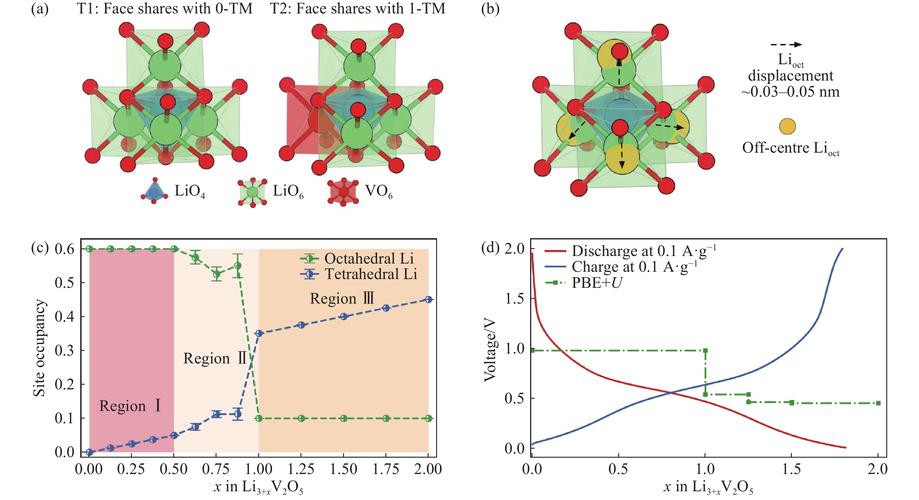
说个很现实的行业现状:刚毕业的博士生,可能能把Kohn-Sham方程的推导写得一字不差,但碰到一个含稀土的催化体系,照样能在泛函修正的选择上踩坑。
我见过最离谱的一个案例,某高校团队发的顶刊论文,算出来的有机分子吸附在金属表面的结合能,比实验值高了40%,后来被人扒出来,用的泛函连最基础的零阻尼色散修正都没加——相当于算范德华力的时候,直接把这部分力扔了。
差一点都不行。
产业端的隐形成本账
很多人觉得计算化学是个省钱的技术,能靠模拟减少湿实验的次数。但很少有人算过,因为泛函修正选错产生的隐形成本,到底有多高。
举个公开可查的例子:某头部动力电池企业在2022年做高镍正极界面副反应模拟的时候,一开始用纯PBE泛函算出来的界面氧释放能垒,比实验值低了近30%。整个材料改性团队沿着这个结果做了半年的掺杂方案试验,烧了近千万的实验经费,最后发现是没加对应的强关联修正和色散修正。把修正项补上重新算,结果和实验值的误差直接压到了5%以内。
现在的产业端,围绕泛函修正已经形成了很微妙的生态:
商业软件厂商把修正项做成了可视化的勾选框,看似降低了使用门槛,但很多默认的参数是针对气相小分子校准的,根本不适合凝聚态的复杂体系;开源软件虽然灵活,但要求使用者对每一个修正项的适用边界了如指掌,稍有不慎就会得到完全错误的结果。
说实话,现在不少企业招计算化学岗,根本不考你会不会手写Kohn-Sham矩阵的对角化代码。
就考一个问题:给你一个具体的体系,你知道该选什么泛函,加什么修正,参数调多少。
这玩意是真的靠经验,没有标准答案。
这种经验壁垒带来的成本,正在慢慢拖慢整个计算化学的产业化节奏。很多中小企业想搭自己的计算化学研发团队,招个有经验的计算化学专家的年薪,已经开到了和资深算法工程师齐平的水平——本质上买的就是对方知道“哪个泛函加哪个修正不会踩坑”的经验。
被所有人忽略的治理风险
这才是最值得警惕的部分。
现在整个AI4Science赛道都在拿计算化学的结果当训练集,训练大模型做材料筛选、药物分子设计。但很少有人去核查,这些训练集里的计算结果,到底有没有加正确的泛函修正。
之前某公开的开源催化剂数据库,被第三方团队复现的时候发现,近一半的计算结果是用未加任何修正的纯PBE泛函算的。下游好几个基于这个数据库做高通量筛选的团队,花了几十万的算力做模型训练,最后筛出来的候选材料连最基础的稳定性都不达标,全部白搭。
更灰色的地带是学术圈的“参数钓鱼”:很多研究者为了让计算结果和实验值对上,会反复调整泛函的修正参数,直到凑出想要的结果。这种操作现在根本没有监管——毕竟计算化学的结果可复现性本来就差,你总不能要求每个作者把每一步调参的过程都写在论文附录里吧?
当越来越多的产业决策开始依赖计算化学的模拟结果,没有人在源头把控泛函修正的规范性,相当于你拿一把刻度歪了的尺子去盖楼,最后楼塌了都找不到责任方。
再过3到5年,这个领域会发生两个很确定的变化。
第一,泛函修正会从现在的“专家经验”,变成标准化的内置模块。现在已经有几个团队在做针对特定体系的预校准泛函包——比如针对蛋白-小分子结合的,针对过渡金属催化的,针对锂电界面的,用户只要选自己的应用场景,软件自动匹配对应的泛函和修正参数,不用再靠自己的经验瞎试。那些号称“万能高精度泛函”的产品会慢慢被淘汰,毕竟没有哪个泛函能在所有体系上都准。
第二,AI会把泛函修正的逻辑嵌到模型的底层。现在已经有不少团队在训练机器学习势函数的时候,把不同泛函的修正偏差当特征喂给模型,让模型自己学习不同体系下需要补的精度差。但别信那些说“AI会完全取代泛函修正”的鬼话——只要密度泛函理论的核心还是对交换关联能的近似,修正就永远存在,只是会从现在的玄学调参,变成更可靠的自动化流程。
上周和那个Biotech的负责人聊到最后,对方说现在团队已经把所有之前跑过的结果,全部重新用带正确修正项的泛函重算了一遍。
花了小十万的算力成本。
但总比再花几百万做错方向的湿实验强。
对吧。
作者|大讲堂
排版|大讲堂
审核|安然