 大讲堂

离谱吧。
很多人现在一提生成模型,第一反应就是GPT、Midjourney、Stable Diffusion,好像VAE这种十几年前的老技术早就该进博物馆了。但真扎到产业一线看就会发现,它根本没退场,只是藏在那些不需要炫技、只算投入产出比的角落里干活。
不是所有生成任务,都需要千亿参数的大模型
先把最容易搞混的概念说清楚:很多人把VAE当成自编码器的变种,其实根本不是一回事。普通的自编码器是个”压缩解压工具”——把输入的图片、文本压成一个低维向量,再解压回来,追求的是输入输出一模一样,本质是做特征提取的。但VAE的核心是造了个可采样的连续隐空间:你不是要把数据压成固定的向量,而是要把所有输入映射成隐空间里的一组正态分布参数,只要你在这个分布里随便抽个点,丢进解码器,就能生成和原始数据分布高度相似的新样本。
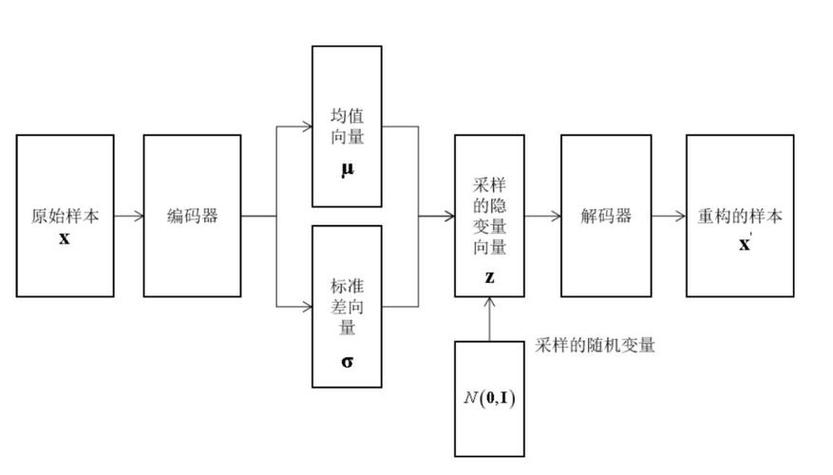
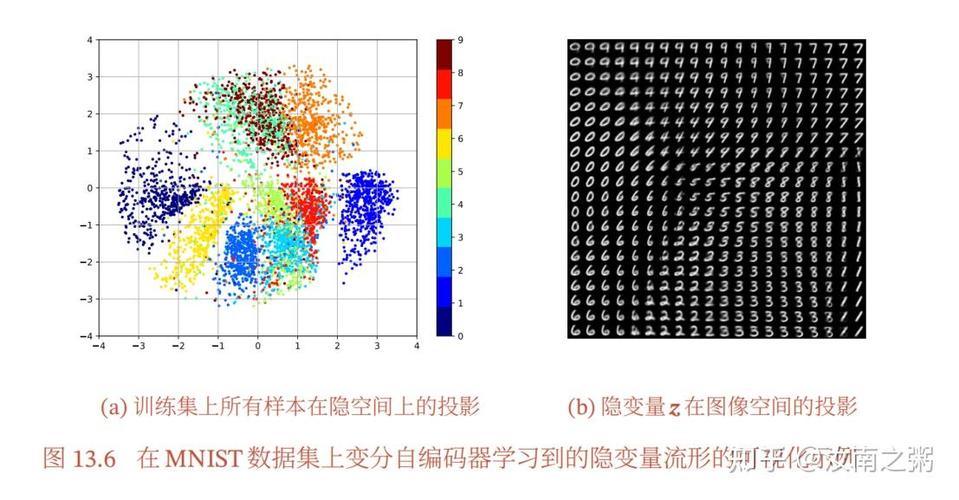
这里最关键的差异是什么?普通自编码器的隐空间是碎的,你随便抽个点生成出来的东西根本没法看,就像你把一堆水果的照片压成了零散的特征块,拼出来的东西要么是半苹果半香蕉的四不像。但VAE因为加了正则约束,把整个隐空间给”铺平”了——你从苹果的分布走到梨的分布的路径上,每一个点生成出来的都是逻辑连贯的水果形态,不会跳变。
说白了,VAE从根上就没打算做”能生成以假乱真的高清人像”这种事。它的优势从来不是生成质量的上限,而是小样本下的稳定性、极低的推理成本、可解释的隐空间。
之前有个误区,很多人说VAE生成的东西糊,不如扩散模型。这就像你拿电动螺丝刀去拧航母的螺栓,然后骂它劲不够——根本没找对使用场景。你要是需要生成4K分辨率的电商模特图,那VAE确实打不过扩散模型,但你要是需要在16G内存的边缘设备上,实时检测工业零件的微小裂纹、给新药研发生成结构相似的候选分子、给推荐系统补全用户的隐式行为,那VAE的优势就出来了:模型体积可以压到几MB,推理延迟只有几毫秒,哪怕你手上只有几百个标注样本,也能训出可用的模型,根本不需要凑几十万的训练数据堆参数。
现在的VAE,早就不是2013年那个刚被提出来的版本了
很多人对VAE的认知还停留在”生成图像很糊”的老印象里,实际上过去三年,产业界对VAE的改造早就超出了原始论文的框架。
最明显的变化是,现在大家不再追求VAE的生成质量天花板,而是把它的核心优势拆出来,拼到各个技术栈里。比如现在主流的扩散模型,其实第一步就是用VAE把高分辨率的图片压到低维隐空间里做扩散过程,不然你算扩散的算力成本能高到天上去——Stable Diffusion里那个被人天天念叨的VAE解码器,本质就是经过工程优化的VAE组件,负责把低维的扩散结果还原成高清图片。
还有更接地气的改造:比如工业界现在用的异常检测VAE,根本不搞什么复杂的生成任务,就是把正常的零件图像喂给VAE,让它把正常特征都映射到隐空间的分布里,只要输入的零件有裂纹、有划痕,它的编码结果就会偏离这个正常分布,解码器还原出来的图像和输入的差得越多,异常的概率就越高。整个模型跑在边缘端的工控机上,不需要联网,不需要大算力,检测精度能到99%以上,成本比传统的机器视觉方案低60%。
当然也有踩过的坑。前两年有团队想拿VAE做大模型的预训练,想把文本都映射到连续隐空间里,结果搞了半年发现,文本的离散特性和VAE的连续假设天然冲突,生成的文本连贯性甚至不如传统的n-gram模型,最后不了了之。说白了,技术没有万能的,找不对边界,再好用的工具也白搭。
别光看生成效果,VAE的产业账算得比谁都明白
现在真金白银在砸VAE落地的行业,没有一个是冲着”炫生成效果”去的。
第一个是制药领域。你想啊,新药研发里最费钱的环节是什么?是找候选分子。传统的方法是化学家对着几百万个分子结构挨个筛,找和靶点结合力强的,一个新分子从筛出来到进临床,平均要花10年时间,几十亿的成本。现在用VAE的逻辑很简单:把所有已知的、有生物活性的分子结构喂给VAE,训出一个对应活性分子的隐空间分布,然后在这个分布里采样,生成几千个结构相似的新分子,先在实验室里做高通量筛选,光这一步就能把候选分子的筛选周期从几个月压到几周,成本砍到原来的1/10。国内已经有好几家Biotech把这套流程嵌到了自己的研发管线里,去年披露的几个进入临床的候选药,前期的分子筛选就是靠VAE做的初筛。
第二个是消费电子的端侧AI。现在大家的手机、耳机、智能手表都要跑端侧的个性化模型,总不能把用户的所有行为数据都传到云端吧?一来隐私合规过不了,二来延迟也高。VAE的模型小啊,几MB的体积,就能把用户的听歌偏好、运动习惯、操作行为都编码成低维的隐向量,在端侧直接做个性化推荐、异常行为检测,根本不需要和大模型抢端侧的算力。之前有个智能手表团队,用VAE做用户的心律失常检测,模型体积压到了2MB,跑在手表的低功耗芯片上,一天的功耗占比不到1%,检测精度和云端的大模型方案差不了2个百分点,这要是换个百亿参数的小模型,手表的电量半天就耗没了。
第三个是工业数字孪生。现在工厂做数字孪生,需要实时把生产线上的传感器数据映射到虚拟空间里,做仿真和预测。VAE的隐空间天然适合做高维时序数据的压缩——几十路传感器的实时数据,压成一个几十维的向量,就能完整保留生产过程的核心特征,哪怕有几个传感器临时故障,也能通过隐空间的分布把缺失的数据补全,比传统的时序预测模型鲁棒性强太多。
当然,VAE的问题也从来没被解决过。
最现实的问题是,它的隐空间虽然是连续的,但解释性根本没大家想的那么强。之前有团队拿VAE做医疗影像的病灶检测,模型能准确把有结节的影像和正常影像区分开,但你问它”到底是影像上的哪个位置、哪个特征导致了这个判断”,它给不出明确的答案——因为整个隐空间的分布是靠正则约束训出来的,不是靠人定义的特征拼出来的。这种”黑箱”问题在医疗、工业这些对可靠性要求极高的场景里,是个硬伤。
还有伦理层面的问题。因为VAE可以在任意数据分布里生成相似的样本,之前就有研究者用VAE在公开的人脸数据集上训模型,生成的人脸虽然不像扩散模型那么逼真,但足够用来做”换脸”、伪造身份信息,而且因为模型体积小,根本不需要什么大算力,普通人在自己的笔记本上就能训一个出来,监管的难度比大模型生成内容高多了。
更有意思的是,现在很多团队为了追求VAE的生成效果,不断往模型里加参数、加复杂的正则项,最后训出来的模型体积比扩散模型还大,推理成本比大模型还高——完全忘了VAE当初被造出来的初衷是什么。
聊到未来的走向,我和几个一线的算法工程师聊过,其实共识挺一致的:
VAE根本不会取代大模型,也不会取代扩散模型,它会变成整个AI技术栈里的”基础零件”,就像现在的卷积神经网络一样,没人会单独拿出来说”我用CNN做了个大项目”,但你在端侧、在工业场景、在制药研发里,到处都能看到它的影子。
第一个明确的趋势是端侧化。未来3年,随着端侧AI的渗透率不断提高,大家对模型体积、推理延迟、隐私保护的要求会越来越高,VAE天生的小体积、低延迟、可在本地训练的特性,刚好踩中这个需求。不会有人在智能手表上跑个7B的大模型,但一定会有人跑一个2MB的VAE模型做健康检测、做个性化推荐。
第二个趋势是和大模型的融合。现在已经有团队在做”大模型做高层语义理解,VAE做底层特征压缩”的混合架构——大模型负责把复杂的任务拆解成低维的特征目标,VAE负责在端侧快速推理执行,既保留了大模型的语义理解能力,又解决了大模型推理成本高、隐私泄露的问题。这种混合架构未来会成为很多行业落地的主流方案,根本不是谁取代谁的关系。
第三个值得警惕的点是,随着生成内容监管的不断完善,专门针对VAE这类小模型的生成内容识别标准会很快出来。毕竟大模型生成的内容现在已经有专门的水印、识别工具了,但VAE因为模型小、部署灵活,反而会成为很多违规内容生成的重灾区,这个领域的治理压力,未来不会比大模型小。
最后说句实在的。现在整个AI行业的风气就是追热点,什么火就一窝蜂扎进去,好像不搞大模型就不算做AI的。但真扎到产业一线看就会知道,能真正帮企业省钱、帮用户解决实际问题的,从来不是那些听起来天花乱坠的技术,而是像VAE这种,不抢风头、默默干活的实用派。
毕竟,技术的价值从来不是看它能生成多惊艳的图片,而是看它能在多少场景里,真真切切把成本打下来,把效率提上去。
作者|大讲堂
排版|大讲堂
审核|阿辰