 大讲堂

上周跟从淘系出来的数仓架构师吃老北京铜锅,他捞起一筷子冻豆腐的手突然顿住。
“现在团队一半的运维精力,都耗在十年前搭的那套星型模型上。”
我夹羊肉的动作也停了。
这东西我太熟了。从刚入行当数仓实习生的时候,就听前辈说星型模型是数仓建模的“银弹”,到现在做了快十年的产业分析,还能在各种技术峰会上听到有人吵——说这东西早就过时了,该被淘汰了。
吵了快三十年,它还在那儿。
别把星型模型当什么高深发明
这东西真的不复杂。
1990年代拉尔夫·金博尔在搞第一代数据仓库的时候,被当时的问题搞烦了:传统的范式建模为了减少数据冗余,把订单、用户、商品、门店的信息拆成了几十张关联表,业务方要查个跨维度的销售报表,得写七八层join,跑一次等半小时。
谁受得了啊?
于是他干脆反过来:把分析最核心的、最大的那张表——一般是交易订单、用户行为这种会不断膨胀的事实表——放在最中间,周围围着一堆相对固定、变化很慢的维度表:时间、地区、商品、用户、门店。所有维度表都直接跟中间的事实表关联,不需要绕来绕去join别的表。
这就是星型模型。
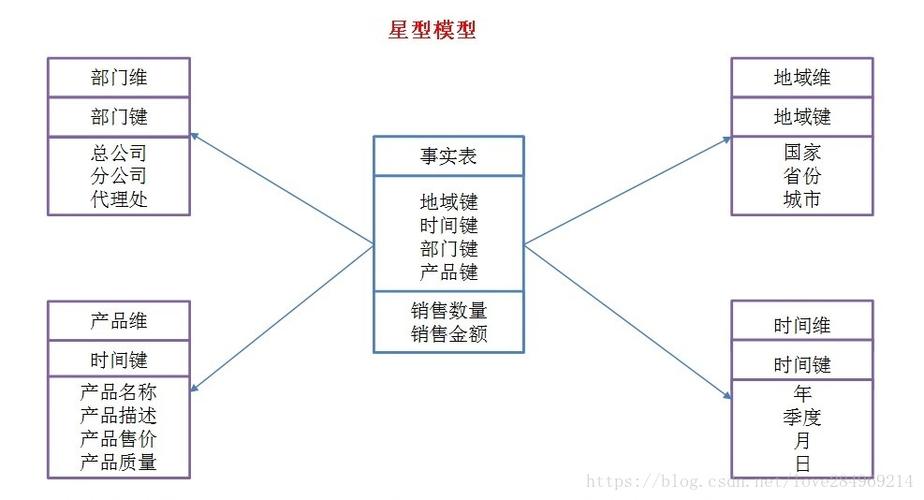
说白了,它的本质就是用一点点数据冗余,换查询速度的指数级提升。它的技术边界非常清晰:只有当你提前明确知道业务要分析的核心维度是固定的、高频的,这套结构才会发挥最大价值。
要是你连业务下个月要查什么数都不知道,硬搭星型模型,那就纯属给自己找事。之前见过一个创业团队,刚拿了融资就花了三个月搭星型模型,维度选了用户性别、所在城市、下单时间三个,结果上线刚俩月,业务方向从卖女装转到了做AI硬件,之前的模型半点儿用都没有,只能全删了重来。
说起来都是泪。
行业里对它的态度,早就裂成了两半
现在你去问做数仓的人对星型模型的看法,能听到完全相反的两个答案。
做传统零售、连锁门店、车企经营分析的团队,把它当宝贝。比如我去年接触的一家在华南开了三百多家超市的连锁企业,2018年搭的那套星型模型,到现在还在跑。为什么?因为他们的分析需求太固定了:每天要算各门店的销售额、库存周转、会员复购率,切的维度永远是门店、时间、商品品类、会员等级这几个。用星型模型搭的数仓集市,业务分析师自己写个三五行SQL就能出数,根本不用排队等数仓团队排期。
而做内容推荐、实时广告、探索式分析的团队,对星型模型的吐槽能写满三页PPT。最离谱的一个项目,是某做短视频的平台,2021年硬套星型模型搭数仓,中间放了张TB级的用户行为事实表,周围一开始只挂了用户、内容、设备、时间四个维度表。才过了半年,业务要分析的维度从4个涨到27个:内容标签的层级、达人的粉丝量级、投放渠道的细分、用户的浏览路径节点……维度表越堆越多,最后整个结构早就不是星星了,像个长了几百根刺的海胆。跑一次全量模型更新要12个小时,比之前用范式建模的速度还慢。
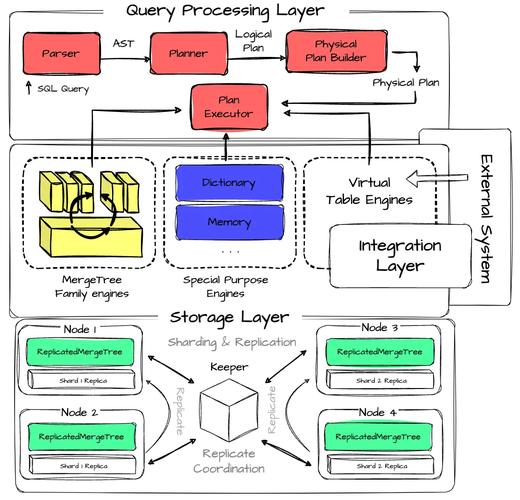
不过话说回来,这几年引擎技术的进步,其实把星型模型的短板给补上了一大块。以前大家用星型模型,最怕join慢,所以拼命把维度表的信息冗余到事实表里,搞的事实表又宽又大。现在像ClickHouse、Doris这类高性能的分析引擎,早就把星型join的优化做进了内核——小的维度表直接广播到所有计算节点,跟分片后的大事实表在内存里直接做匹配,根本不需要复杂的冗余设计,跑一次查询的速度比十年前快了十几倍。
被骂了这么多年,它为什么还没被淘汰
很多人说现在都搞湖仓一体了,都提倡schema on read了,不需要提前建模,星型模型自然就没用了。
真不是。
你想啊,数据湖存了几百T的原始日志,灵活是灵活,可你让一个刚入职的运营分析师对着一堆没清洗的日志写SQL,找上个月华东区所有门店的满减活动ROI,他得先自己写逻辑把订单状态、退款金额、优惠券抵扣、活动参与时间这些字段理清楚,半天才出一个数,最后口径还跟财务部门对不上。
这时候你就知道星型模型的好了。星型模型的核心价值从来不是技术先进性,而是极低的认知门槛和统一的分析口径。不管你是刚毕业的分析师,还是管销售的大区总监,只要看到“销售事实表”“时间维度表”“地区维度表”,就知道该怎么查数,不用每次都拉会对齐“你这个GMV到底算不算退款”“复购率的计算周期是30天还是90天”。
我去年去看某头部新能源车企的用户运营团队,他们的数仓系统里,80%的日常查询请求,都是对着一套2019年搭的星型模型发的。没人觉得这东西老——只要它出数快,口径统一,没人愿意折腾。
甚至现在很多做实时数仓的团队,反过来把星型模型当成了标配。比如门店的实时客流大屏、电商的实时交易大盘,每几秒就要刷新一次数据,你总不能让大屏每3秒就去join一堆原始日志吧?提前把维度信息做好,事实表按分钟粒度更新,星型结构一搭,大屏跑起来稳得一批。
不过话说回来,星型模型的坑,真的踩过的人都知道有多疼。
最大的一个坑,就是没有统一标准的“野蛮生长”。很多公司当年搭星型模型的时候,各个业务团队自己搭自己的:零售团队建了张“用户性别”维度表,算的是用户注册时填的信息;运营团队也建了张同名的维度表,算的是用用户行为推断出来的性别。最后两个表查出来的数对不上,各个部门互相甩锅,开了三次会都没搞清楚哪个是对的。
还有个更隐蔽的问题,就是星型模型的固化性带来的思维局限。你在搭模型的时候把维度定死了,团队的分析视角也就被框住了。比如之前某电商团队,连续五年都围绕“品类、地区、时间”三个维度搭星型模型做经营分析,从来没考虑过要加“用户内容偏好”的维度,直到后来被竞品从内容推荐的方向打了个措手不及,才反应过来——自己的数仓里根本没有对应的维度数据,想做相关的分析,得花半年时间重新梳理日志、搭模型,等数据攒够了,市场份额早就被抢光了。
哦对,还有最现实的问题:当年搭模型的人离职了,留下来的文档写得乱七八糟,后来接手的人根本不知道这个维度表当时是按什么逻辑建的,改也不是,不改也不是,就那么一直凑合用。我之前见过最夸张的一个数仓,一套星型模型跑了八年,中间换了五波团队,没人敢动——怕一改就出数错,担不起责任。
很多人现在问我,星型模型未来会不会彻底消失?
我觉得不会。
未来三到五年,它的定位会慢慢调整:不会再像十年前那样,作为整个数仓的核心建模方法覆盖所有场景,而是退到“固定分析场景的专用集市层”——也就是说,你要做灵活的、探索式的创新分析,就去湖仓的原始数据层随便折腾;要做跨部门统一口径的、高频的经营分析,就用星型模型搭一套稳定、好懂、快的专用层。
而且现在的AI数仓工具,其实在反过来给星型模型提效。以前搭一套覆盖核心经营场景的星型模型,数仓团队要花几周时间梳理指标、对齐口径、建表测试,现在AI工具可以自动从原始日志里识别高频查询的维度和事实指标,自动生成星型结构的模型,自动校验口径一致性,把之前几个月的工作量压缩到几天。
别信什么“无建模时代”的鬼话。只要企业内部还有跨部门的数对齐需求,就一定需要一套所有人都能看懂、口径统一的模型结构。星型模型因为足够简单、足够直白,没有那些花里胡哨的设计,大概率还会在这个位置待很久。
快才是硬道理。
对吧?
作者|大讲堂
排版|大讲堂
审核|白杨