 大讲堂

上周跟某股份行数据中心的老陈吃饭。
他吐槽说,团队现在一半的人在维护两套代码:一套算实时交易风控,一套算T+1的客户画像。光两边的口径对齐,每个月就要耗掉2个人天。
这是过去十几年所有玩大数据的团队,绕不开的糟心循环。
实时链路要低延迟,批链路要高吞吐,两套引擎、两套代码、两套校验逻辑,算出来的数对不上是常事。业务部门拿着实时报表说今天转化率涨了20%,批处理的T+1报表出来一看,实际只涨了8%——最后锅永远是数据团队背。
流批一体这个概念,就是在这种糟心的土壤里长出来的。
别被厂商忽悠:流批一体从来不是“一套代码跑所有”
很多厂商的宣传把流批一体吹成了万能药,好像只要上了这个架构,所有的大数据问题都能解决。但实际上,流批一体的核心边界非常清晰:它要解决的是“同一套业务逻辑,无界流处理和有界批处理的语义一致性问题”。
之前的架构是什么样的?流处理用Flink,盯着持续进来的用户点击、交易数据,秒级算出当前的实时指标;批处理用Spark,每天凌晨拉过去24小时的全量数据,算出准确的历史大盘。两套系统的逻辑是分开写的:流处理为了低延迟,可能会做近似计算,会跳过一些重复数据;批处理为了准确性,会全量校验所有数据,会重算所有历史窗口。两边只要差上1%,业务部门的报表就得打回来重算。
真正的流批一体,是从最底层的API、状态存储、调度逻辑做统一,让开发者只需要写一遍业务逻辑——比如“统计过去10分钟的用户下单量”——这段代码既能对着无界的实时数据流跑,做到秒级延迟,也能对着有界的历史数据集跑,做到全量准确重算。
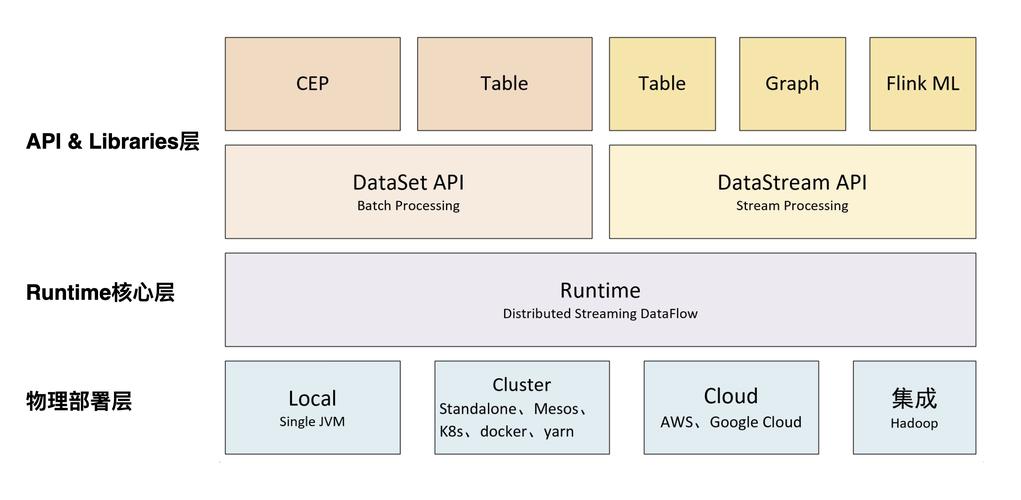
说实话,我2018年第一次听厂商讲流批一体的时候,差点把手里的冰美式喷出来。当时的方案本质就是给Spark套了个Flink的API壳,跑个简单的WordCount还行,真要算复杂的会话窗口逻辑,批模式跑出来的结果跟流模式差了快30%。这不叫一体,叫贴皮。
从“贴皮方案”到真落地:行业现在摸到哪一步了
这几年整个行业的进展,比我预想的快。
开源社区这边,Flink从1.10版本开始做流批融合的引擎重构,到1.18版本的时候,已经能做到SQL层90%以上的语义对齐——同一段统计用户留存的SQL,跑实时链路是3秒级延迟,跑批链路是全量重算过去90天的历史数据,两边的结果误差能控制在0.1%以内。这个精度,已经够绝大多数生产场景用了。
落地的案例也不再是实验室里的Demo。某头部外卖平台去年把整个骑手调度的核心链路切到了流批一体架构上:之前实时算骑手接单率用Flink,每天的运营大盘用Spark跑批,两边算出来的接单率差了2个百分点,运营团队天天跟数据团队吵架——毕竟差2个百分点,对应的就是每天几百万的调度成本。切了流批一体之后,同一份逻辑,实时链路算当前的实时接单率,批链路算过去30天的历史均值,口径完全统一,光跨团队对齐口径的人力就省了70%。
不过话说回来,别信那些销售说的“上了流批一体能省50%算力”的鬼话。我问过三个已经把核心链路迁到生产的技术负责人,实际情况是:迁移初期,算力成本反而涨了15%-20%——因为你要把之前两套链路的逻辑全部重构,还要做至少3个月的双跑校验,等跑顺了,长期看能省的从来不是算力,是天天对齐口径的人力。
没人说的暗坑:流批一体不是万能解药
现在行业里聊流批一体,全是优点,没人说那些踩过的坑。
第一个坑:小团队根本玩不起。流批一体架构对状态存储的稳定性、运维的复杂度要求,比单独跑Spark或者Flink高一大截。那种十几个人的创业公司,为了省那点写两套代码的人力,硬搭一套流批一体架构,光日常运维的成本就能把团队拖死——你得有人专门调优状态后端,专门处理流批切换的异常,专门做结果校验,算下来还不如老老实实分开写两套代码划算。
第二个坑:语义对齐是有边界的。现在的流批一体引擎,能搞定80%的常规统计场景,但剩下20%的复杂场景——比如需要跟多维度外部维表做关联的、需要处理极端乱序数据的、需要做精确去重的——还是会出现流和批的结果差异。之前某电商大促的时候,实时链路算的GMV是1.2亿,批链路重算的时候是1.18亿,差的那200万,就是因为实时链路的商品维表更新延迟了30秒,批链路用的是全量静态维表。这种差异你说大吧,也不大,但财务对账的时候就是会揪着你问。
第三个坑,也是最影响产业化的:流批一体的生态碎片化,已经成了最大的堵点。现在没有统一的行业标准,每个大厂都在搞自己的流批一体API:阿里的Blend、字节的ByteFlink、云厂商各自的托管组件,API都是不兼容的。你今天用了A厂商的组件,明天想换B厂商,迁移成本跟重新写一遍没区别。这种碎片化的生态,最后只会把中小玩家挡在门外。我见过最离谱的案例,某制造企业花了两千万上了一套流批一体系统,最后发现连车间的设备数据都接不稳,钱全打了水漂。
聊点实在的,未来3到5年,流批一体肯定不会像厂商吹的那样,把所有传统的数仓、批处理链路全部换掉。
第一波真正能吃到确定性红利的,是那些本来就有几百人数据团队的中大型企业——比如全国性的股份制银行、头部外卖电商平台、大型物流企业。他们之前光维护两套链路的人力成本,每年就大几千万,就算迁移要花几百万,算下来两三年就能回本。
小团队别凑这个热闹。与其折腾复杂的流批一体架构,不如直接用云厂商的托管数仓,把精力放在业务上,等开源社区的方案足够轻量了再说。
还有个很现实的预判:未来两年,肯定会有一波厂商拿“流批一体”的概念割韭菜,专门给那些没有技术判断力的传统企业卖高价方案,最后落地的时候发现,连基本的口径对齐都做不到。遇到这种吹得天花乱坠的销售,直接让他演示同一段代码跑流和跑批的结果差就行,差超过1%的,直接送客。
技术从来不是越新越好。流批一体解决的是真问题,但它从来不是所有场景的最优解。对吧。
作者|大讲堂
排版|大讲堂
审核|白杨