2026-10-14 21:01:53 作者:大讲堂
2026年开春我去杭州参加一个车企内部的技术复盘会。
刚进门就撞见两个技术总监拍桌子。
一个骂当初砸3000万搭的全域数据湖成了没人敢碰的烂摊子,一个骂当初选型时被云厂商销售的PPT忽悠瘸了。
会议室空调开得太足。
满桌的报销单堆着,每一笔都是真金白银。
2026年的会议室,没人再信数据湖的PPT神话
同一份用户全链路行为标签的月度批处理任务,2024年在传统数仓上跑一次成本是1170块,2026年迁到号称“存算分离、弹性扩容”的湖仓架构上,单次跑批成本直接跳到8420块,算下来一年光这一个任务的算力开支,够给整个车企的用户运营团队发14个月的全额年终奖。
 2026年车企数据湖成本核算复盘会现场
谁能想到当初吹得神乎其神的“存任意格式数据、随取随用”,最后真成了什么数据都敢往湖里扔——用户上传的身份证扫描件、4S店的维修工单PDF、路测采集的12K激光雷达原始点云、甚至市场部做活动的背景音乐MP3,一股脑全丢进对象存储,没有元数据登记,没有权限分层,谁找数据谁翻三天三夜。
没人敢删。
怕删错了担责任。
最后整个湖的存储量从最初设计的200TB,两年涨到了1.7PB,其中能被分析师真正调用的数据占比,还不到6%。
当初销售在PPT上画的“全场景数据打通、任意格式实时查询”的饼,到最后变成了跨源查询要等40分钟、找个历史数据要翻十几个权限目录的烂摊子,换谁都得窝火。说实话我当时听着都替他们肉疼——花了大价钱搭的湖,最后连个能直接用的报表都跑不顺畅,这钱花得比给老板买高尔夫球卡还冤。
湖仓博弈的底牌,从一开始就不在技术侧
很多人以为数据湖变成沼泽是技术不够成熟,其实根本不是。数据沼泽的本质从来不是技术bug,是成本结构的错配。
传统数仓是什么?是高度结构化的精装小区,数据进库之前就要做清洗、建模,相当于每栋楼什么户型、住了谁都登记得明明白白,管理员要对每一份数据的准确性负责。而云厂商卖给你的数据湖,本质上是一片围起来的野地——按你占的面积收租金,按你在地上跑的车数收过路费,至于你在地上堆什么、堆得乱不乱,人家根本不关心。
这逻辑和当年生鲜电商的前置仓博弈简直一模一样——你以为仓里堆的是能快速配送给用户的鲜切果盘,实际上一半是临期临保的库存、一半是被供应商塞进来凑数的滞销货,最后仓租交了一堆,真正能产生复购的货没几样。
举个我接触过的深圳本土跨境电商的例子。2023年他们花了大价钱从传统Oracle数仓迁到基于开源Iceberg搭建的开源数据湖,一开始算的账是存储成本能比原来降40%,结果跑了18个月,他们的技术负责人跟我吐槽,因为没有统一的元数据治理,每个业务线的团队都在自己的分区里存重复的数据集——光“欧洲站用户复购率”这个指标,就有8个不同的版本,每个版本的计算口径差得十万八千里,最后为了对齐口径,专门搭了个12人的数据治理团队,一年人力成本就2000多万,算总账比之前用Oracle数仓的时候贵了整整一倍。
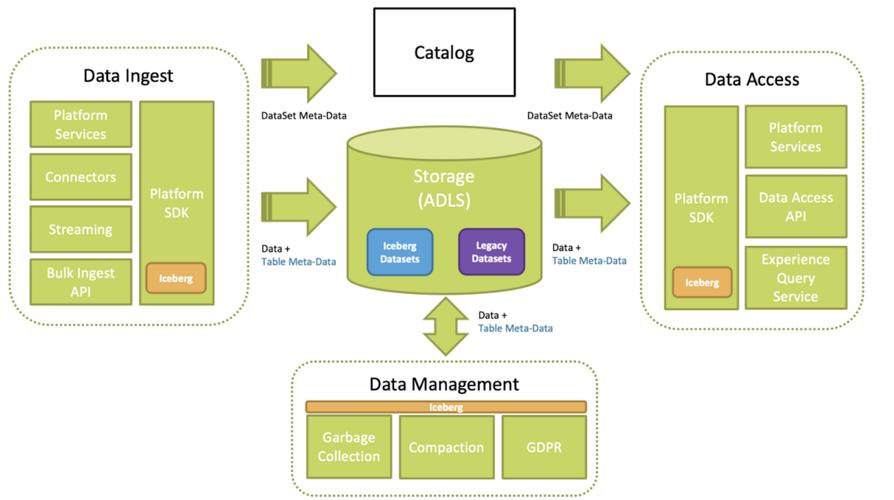 开源数据湖Iceberg元数据分层架构示意图
他们后来拉了个账单算细账,18个月里在数据湖上花的冤枉钱,相当于把整个深圳南山的腾讯滨海大厦公共区域的电费交一整年。真没夸张,我看过他们的账单明细,存储冗余占了总开支的52%,重复计算的任务占了31%,真正用在有效分析上的钱,连零头都不到。
说白了,没有治理能力的存储扩容,本质上是给云厂商做慈善。你往湖里多存1TB的冷数据,云厂商就多收你1TB的存储费;你多跑一个重复的分析任务,云厂商就多赚你一份计算的钱。从商业模式上,卖你数据湖解决方案的厂商,从来没有动力帮你把湖里的浑水澄清——毕竟你越乱,他赚的越多。
不过话说回来,也不能全怪厂商套路。很多企业当初上数据湖,根本不是从自己的业务需求出发,是看隔壁友商都上了,自己不上就落后了——这种跟风的决策,最后踩坑太正常了。
卷了五年,最后给数据湖擦屁股的是普通打工人
 卷了五年,最后给数据湖擦屁股的是普通打工人
现在很多刚入行的年轻人被网上的教程忽悠,花大几千块报班学湖仓一体的开发,出来找工作的时候才发现,大部分企业招的根本不是能从零搭湖的架构师,是能给烂湖擦屁股的治理工程师——说白了就是天天对着元数据目录,把乱堆的数据分类、打标签、删冗余,干的活和写字楼的物业保洁没什么区别。
我认识个在杭州做数据开发的小伙子,去年跳去那家车企做数据湖治理,每天的工作就是给湖里存的MP3文件、PDF扫描件打标签,判断哪些是可以删的冗余数据。干了半年他跟我说,最崩溃的一次,他翻到3年前市场部存的一个12G的活动视频,里面连个字幕都没有,根本不知道是哪场活动的,删了怕担责任,不删每个月还要交几十块的存储费——这种没意义的内耗,每天都在各个企业的数据团队里上演。
技术选型从来不是越新越好,是算得清账才好。2026年的企业早就醒过来了,不再拼谁的湖容量大、谁的技术栈新,开始掰着手指头算每一分钱的投入产出。我知道的一家连锁餐饮企业,之前跟风上了数据湖,现在直接把湖里70%的冷数据全删了,只留3年以内的结构化交易数据,剩下的全存在低成本的磁带库上,一年省了近千万的存储费。
别再被那些“未来十年是数据湖时代”的鬼话骗了。你要是个100人不到的小团队,放着现成的云数仓不用,非要自己搭开源数据湖,那纯属是给自己找罪受。我见过太多团队,为了追技术潮流,把本来应该花在业务洞察上的精力,全耗在了和湖里面的乱数据死磕上——最后业务没做出成绩,技术团队倒是先卷不动了。
等所有企业都算清数据湖的真实投入产出那天,你猜最先跑掉的,是当初拍胸脯保证“上湖必涨效”的云厂商销售,还是天天在冗余数据里捞有效信息的技术工程师?
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:数据湖不是技术命题,是企业算力账单的修罗场
文章链接:https://www.lfdjt.com/info_23_25909.html
 大讲堂
