2026-10-14 20:46:52 作者:大讲堂
去年深秋去张北某云数据中心调研,踩在冷通道的防静电地板上,刚蹲下去摸服务器进风口的金属网,冰得一缩手。
旁边半开放的热通道里,运维小哥举着测温枪扫过服务器出风面,47度。
那一瞬间突然反应过来:我们聊了十几年的“冷热分离”,根本不是什么写在教材里的抽象概念——它就是脚底下吹出来的18度冷风,是服务器后面排出来的滚烫热风,是现在所有AI算力玩家抠破头要抢的降本密码。
别搞错了:冷热分离的技术边界从来不是只给机房分冷热区
很多人对冷热分离的认知还停留在十年前的机房改造:给冷通道装个玻璃门,把热风吹到服务器外面别乱飘,降个PUE就算完事。
真的冤。
现在产业语境里的冷热分离,早就拆成了三个完全独立又互相打通的层级,根本不是单指物理散热。
最底层是物理空间的冷热分离:核心目标是减少冷热源的无效掺混,用最少的电把需要降温的设备维持在合适温度,别让冷风和热风在机房里瞎搅和,最后花了两倍的电,还把服务器烘得频繁降频。之前有个做游戏的大厂早年踩过坑,砸了两千万做冷热通道封闭,忘了在吊顶上装风阀,冷气流全顺着吊顶飘去了办公区,最后测出来PUE只降了0.018,钱打了水漂。
往上一层是存储层面的冷热数据分离:把访问频率高、需要低延迟响应的“热数据”放在读写速度最快、成本最高的存储介质里,把访问频率极低、几个月甚至几年没人碰的“冷数据”下沉到成本极低、读写速度慢一点也没关系的存储层。说白了就是别让天天要翻的身份证占着保险柜的位置,也别让几十年前的旧报纸堆在前台最显眼的地方。
最顶层是算力调度的冷热任务分离:把需要毫秒级响应的实时推理、在线交易这类“热任务”,优先分配给延迟最低、性能最强的算力节点,把跑一整晚的离线训练、数据清洗、批量渲染这类“冷任务”,塞到闲时的算力资源里跑,别让抢着付钱的用户等着批处理任务跑完GPU。
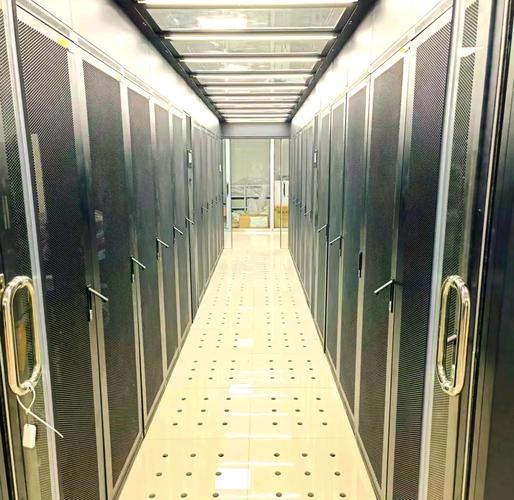 数据中心冷热通道隔离布局实景图
很多人容易把这三个层级混为一谈,比如提到冷热分离就只谈机房散热,实际上现在真正能把成本打下来的玩家,都是把三层打通了做的。你想啊,如果存储层把热数据全放在了最廉价的冷存储上,哪怕机房把PUE降到1.0,用户点个按钮等三秒才出结果,业务不还是得崩?
现在的玩家,已经把冷热分离玩出了什么新花样
说实话,这两年AI大模型把算力成本抬得太高,大家才突然发现,之前靠堆硬件、堆存储、堆电力的粗放玩法根本玩不起,转头就把十几年前的老概念——冷热分离,捡回来玩出了花。
先说最成熟的物理散热层。现在头部的智算中心做冷热分离,早就不是简单装个玻璃门了。比如冷板式液冷方案,直接把冷却液通到CPU和GPU的散热片上,热量根本不经过机房空气,直接通过冷却液带到冷却塔排出去,冷热交换路径短到离谱,PUE能压到1.1以下。还有更狠的,直接把服务器泡在绝缘冷却液里,连风扇都不用装,热量直接从液体里导出去,冷热完全不掺混。
然后是现在最热的向量数据库冷热分层。做过大模型推理的都知道,向量索引是整个推理链路里最占存储成本的部分:用户每发一个问题,系统要从几十亿条向量里搜出最相关的几条,拼接成上下文喂给大模型。之前大家怕延迟高,把所有向量全放在NVMe全闪盘里,一个月的存储成本能压垮一个创业团队。
去年碰到个做电商大模型的创业公司,之前全闪存向量,每个月光存储钱就一百二十万,算下来毛利率直接被砍了18个点。后来他们给向量库加了冷热分层:用户7天内点击过的商品对应的向量,全放在全闪里;30天没人点的商品向量,下沉到低频对象存储;超过半年没被检索过的历史向量,直接归档到磁带库。改完之后每个月存储成本直接降到十八万。
省下来的钱够给整个算法团队发三个月奖金。
当然也有踩坑的。有个做内容推荐的公司,照着网上抄的阈值,把7天没访问的数据全定义成冷数据,结果碰到去年双11,用户突然开始翻三年前买过的商品记录,冷数据调取延迟直接飙到400毫秒,用户点个“查看历史订单”的按钮,要等半秒才能跳出来,那一周的用户留存直接掉了7个点。
这种为了降本而降本的方案,纯纯是懒。
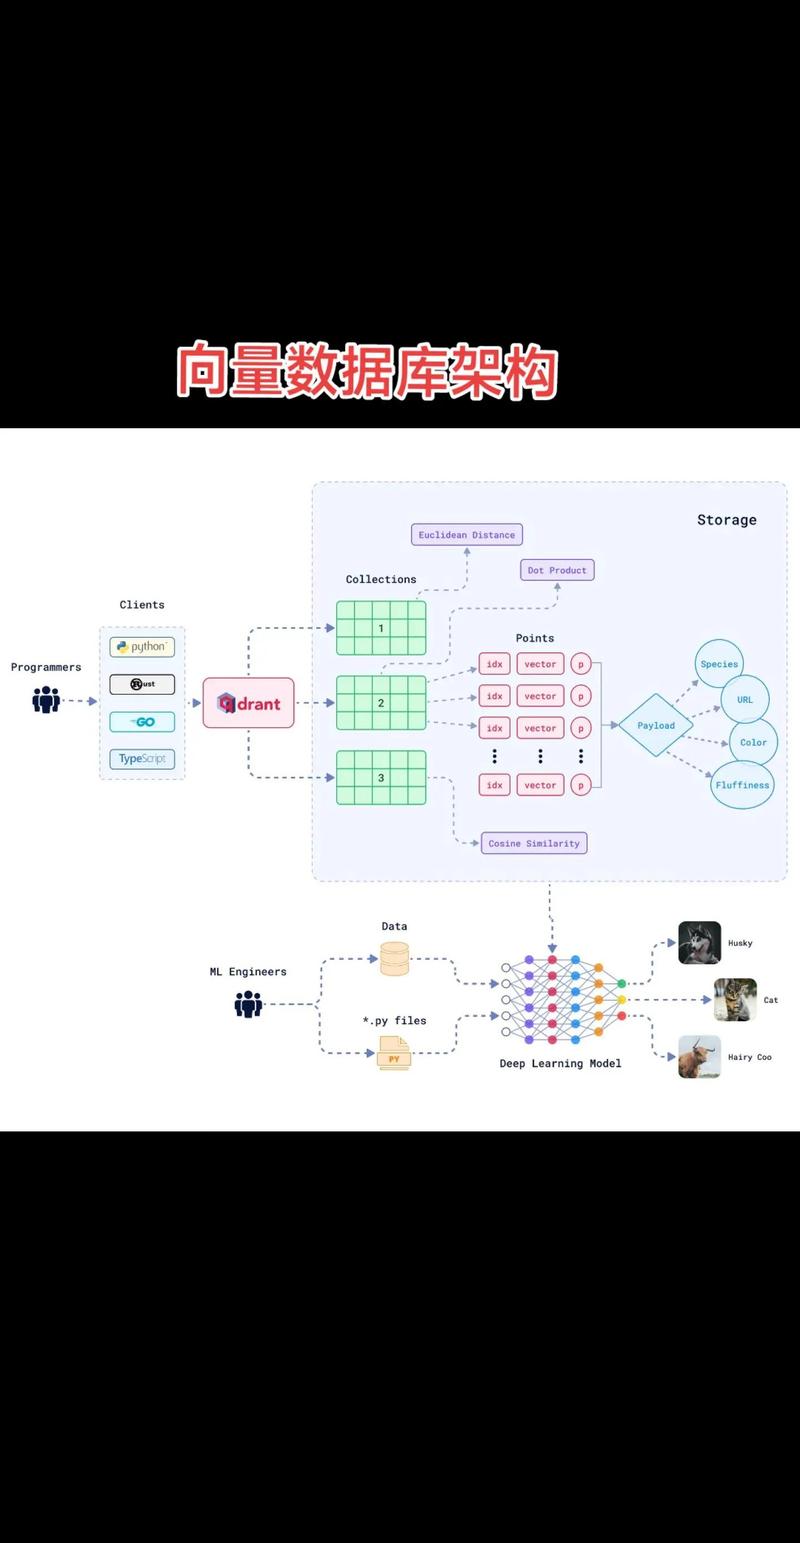 向量数据库冷热数据分层架构示意图
没人愿意提的雷区:冷热分离从来不是免费的午餐
 没人愿意提的雷区:冷热分离从来不是免费的午餐
很多宣传稿把冷热分离吹得像降本神器,好像只要把数据分个冷热,成本就能砍大半,实际上真落地的时候,坑多到能把人埋了。
第一个坑就是冷热边界的识别成本。很多中小公司根本没有能力做动态的冷热判断,照着大厂的固定阈值抄,要么就是把热数据错放到冷存储里导致业务延迟飙升,要么就是把冷数据错留在热存储里,钱根本没省下来。现在要精准识别冷热边界,得给所有数据访问行为埋点,得跑日志分析,得用算法预测哪些数据接下来会被访问,这套系统的搭建成本,对很多小公司来说根本负担不起。
第二个坑是老基础设施的改造门槛。很多建了五六年的老机房,当初设计的时候根本没考虑冷热通道封闭,层高只有3米,上送风的风道全在吊顶里,要改冷热分离,得把整个吊顶拆了重新装风阀,得改消防喷淋的位置,得重新布冷水管,算下来改造成比新建一个机房还贵。
更别说那些没人提的治理风险。比如现在算力调度的冷热分离,很多云厂商已经开始玩“优先级竞价”了:付费高的大客户的热任务,直接占满最好的GPU节点;付费少的中小客户的冷任务,哪怕交了钱,也要等大客户的任务跑完才能排队跑。说穿了就是算力资源的“价格歧视”,你要是急着跑实验,就得掏三倍的钱插队,这算不算另一种形式的不公平?
还有冷数据的安全问题。很多公司把冷数据归档到磁带库之后,根本没人定期盘点,等监管要求调取某三年前的用户数据的时候,翻半天才发现磁带放在潮湿的仓库里发霉了,数据读不出来,等着被罚吧。
聊点实在的,未来三到五年,冷热分离会往三个方向走。
首先,全栈式冷热分离会成为所有智算中心的标配。再也不会出现机房运维部只管温度、存储部只管数据分层、算力调度部只管任务排队的割裂状态,三个部门的数据会全部打通:机房的温度传感器数据、存储的访问日志、算力的任务优先级,全部接入同一个调度系统,动态调整冷量供给、数据分层阈值、算力分配比例。比如预测到接下来两个小时会有大流量高峰,系统会提前把对应的热数据从冷存储预热到全闪里,把闲时的冷任务临时暂停,把算力资源腾出来给热任务,既不浪费电,也不浪费存储,还不耽误业务。
其次,AI会成为冷热边界识别的核心工具。之前靠人工设固定阈值的时代会彻底过去,用轻量的小模型实时预测每一条数据、每一个任务的冷热程度,提前做资源调配,根本不会出现大促期间冷数据调取延迟的问题。
最后,专门的冷数据基础设施会出现爆发式增长。现在已经有公司把冷数据存在青海的地下天然洞穴里,常年15度的恒温,根本不用额外制冷,搭配低功耗的磁带存储,每TB一年的存储成本不到一块钱。未来三年,这种专门的冷存储节点会在西北、西南的能源充足地区大规模建起来,所有不怎么需要访问的历史数据、备份数据,都会往这些地方迁。
说穿了,冷热分离从来不是什么高大上的技术发明。
就是别浪费。
热的东西给够资源,冷的东西压到最低成本,别让冷风去吹墙,别让贵的存储存没用的数据,别让闲的算力闲着。
之前大家被算力过剩、存储过剩的幻觉冲昏了头,现在AI算力的成本越来越高,大家才突然反应过来——
不浪费,才是最大的降本。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:冷热分离:AI算力时代藏在成本账单里的隐形革命
文章链接:https://www.lfdjt.com/info_23_25907.html
 大讲堂
