2026-10-14 20:02:00 作者:大讲堂
说真的,我见过太多团队把弹性伸缩当云厂商送的一键魔法按钮。
去年帮一个做直播电商的客户做架构复盘,大促当天提前10分钟按演练好的策略扩容,结果新扩的20台应用实例一上来就把数据库的连接池打满,整个直播间卡顿3分钟,直接损失了小几十万。运维团队事后复盘的时候脸都是白的——他们根本没意识到,自己配的扩容策略,从一开始就没算过下游依赖的承载上限。
你以为的弹性伸缩,可能从根上就配错了
很多人对弹性伸缩的认知,还停留在”CPU高了就加机器,CPU低了就减机器”的层面。但真往深了拆,这套机制本质是三层联动的系统:最上层是流量感知层,要能实时抓到从网关到应用到数据库全链路的负载数据;中间是决策层,要根据感知到的数据判断现在该加多少资源、什么时候加、加了之后会不会把下游压垮;最下面是执行层,要能快速把新的资源拉起来、配好网络、把流量切过去。
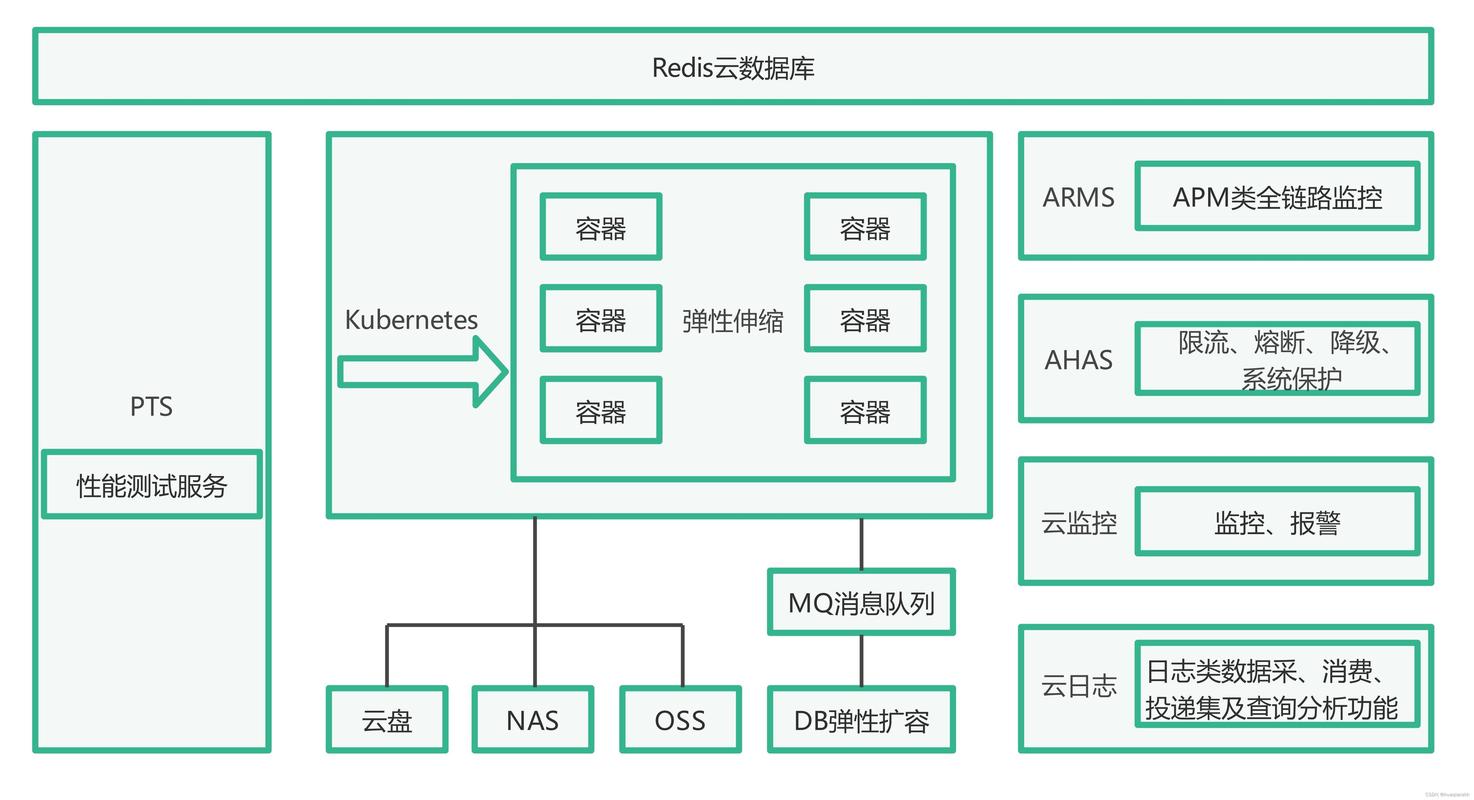 云原生弹性伸缩三层架构流程图
这里最容易踩的坑,就是很多团队只盯着最下面的执行层,把前面两层全省了。
我见过最离谱的配置,是把扩容冷却时间设成了0。流量稍微抖一下就触发扩容,一次加20台,等流量掉了又秒缩回来。最后账单出来的时候,运维看着数字直接把咖啡喷在键盘上——光这部分临时扩容的费用,就够他们团队发两个月奖金。
更关键的是,弹性伸缩的天花板从来不是云厂商能给你开多少台虚拟机,是你整个应用架构的解耦程度。如果你的服务是单体架构,所有逻辑都挤在一个进程里,就算给你扩100台实例,每台都要连同一个十几年前买的商业数据库,最后数据库连接数先到顶,啥弹性都没用。我见过太多团队花了大价钱买了最高阶的云服务套餐,结果架构还是十年前的老样子,弹性伸缩配得再花哨,遇到流量高峰还是该崩就崩。
跑了十年的弹性伸缩,现在卡在了”感知不准”这道坎上
从最早的基于CPU、内存这些基础设施指标扩容,到后来能对接应用层的队列长度、接口延迟,弹性伸缩的技术迭代其实已经跑了快十年。但直到今天,它还是没跨过最核心的那道坎:反应太慢。
从触发扩容到新的实例把服务拉起来,装完依赖、把连接池预热好、把缓存热数据加载完,至少要3到5分钟。这还是在一切顺利的理想状态下,如果碰到云厂商的资源池临时紧张,等新机器分配下来可能都过了10分钟。等你反应过来该扩容的时候,用户早就因为接口超时退出去了。
现在整个行业都在盯着这个问题找解法。最早的思路是提前按峰值预留资源,但那样成本太高,跟固定买服务器没区别;后来大家开始做预测式扩容,把历史的流量曲线、大促的时间节点、甚至外部的舆情数据(比如某个主播的开播预告、某个短视频的传播热度)喂给模型,提前15到30分钟把资源扩到位。
 弹性伸缩基于流量预测的扩容时序对比图
但说实话,这套预测模型的准确率,碰到完全无征兆的爆点流量,跟蒙也差不了多少。去年618有个做休闲零食的客户,本来按前两年的峰值把资源留到了平时的8倍,结果老板临时在自己朋友圈发了个专属优惠券链接,10分钟内流量冲到了平时的30倍,模型直接傻了,扩容策略完全跟不上,最后还是靠人工手动加了40台机器才把流量扛住。
这两年还冒出来一批创业公司,根本不自己做云资源,就盯着弹性伸缩的决策层做文章。现在很多做可观测性的创业公司,根本不自己做云,就盯着弹性伸缩的决策层做文章,把全链路的追踪指标、业务的转化数据全打通,帮客户算最优的扩容阈值——不是等CPU到80%才扩,而是只要接口延迟到200ms就触发扩容,在不影响用户体验的前提下尽量少加机器。就这一块业务,去年整个赛道的收入差不多翻了一倍。
别把弹性伸缩当省钱工具,它的账单坑能埋了整个团队
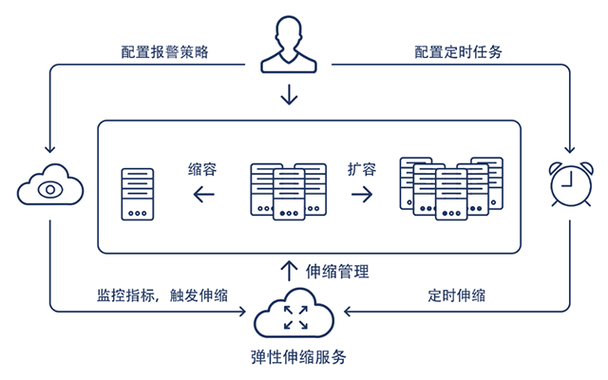 别把弹性伸缩当省钱工具,它的账单坑能埋了整个团队
很多云厂商的销售给客户推弹性伸缩的时候,总爱说一句话:用了这个功能,你不用按峰值买资源,能省一半的钱。
这话听着特别美好,但真落地的时候,十家企业有八家会在账单上踩坑。
我之前接触过一个做在线教育的团队,前两年为了应对每天晚上的上课高峰,把弹性伸缩的阈值设得特别保守——只要CPU到30%就扩容,生怕上课的时候卡了影响体验。结果用了一年多,财务过来对账才发现,他们每个月的云账单比同规模的团队高60%。原来他们的缩容策略设成了”连续30分钟低负载才释放实例”,每次上课结束后,总有几个老师在后台录课程,占了一点CPU,那些扩出来的实例就一直留着不释放,算下来一年多花了快两百万。
这其实是很多企业现在面临的共性问题:弹性伸缩从来不是配一次就一劳永逸的功能,它需要长期的调优、持续的成本核算。但现在大多数团队的现状是,开发只管把功能上线,运维只管服务不崩,没人盯着弹性伸缩的配置是不是真的在省钱。最后整个云账号里的资源碎得一塌糊涂,你想统一缩容吧,怕把别人正在用的服务给缩没了;你想留着吧,每个月的成本高的吓人。
站在现在的时间点往未来3到5年看,其实有几个趋势已经很清楚了。
第一,弹性伸缩不会永远是云厂商绑定客户的标配功能,未来一定会出现跨云的独立决策层。不管你用的是阿里云还是AWS还是自建机房,都能通过统一的策略调度所有资源,不会再因为某一家云的弹性能力不够,就被绑定在单一的平台上。
第二,弹性伸缩的决策标准会彻底从”看基础设施指标”转向”看用户体验”。以后没人会盯着CPU占了多少、内存用了多少来决定要不要扩容,核心判断标准只有一个:当前的并发下,用户的请求会不会超过可接受的延迟阈值。毕竟用户根本不关心你服务器的CPU跑了多少,只关心自己点按钮的时候能不能立刻加载出来。
第三,成本会成为弹性伸缩决策模型里的核心变量。未来的弹性扩容不会再为了”绝对不崩”就无限加资源,而是会在”不影响核心用户体验”和”不花冤枉钱”之间找平衡——比如碰到流量低谷的时候,自动把非核心的推荐服务、日志采集服务缩到最小的资源配额,把省下来的资源留给支付、登录这些核心链路。
说穿了,弹性伸缩从来不是什么高深的黑科技。它本质上是在帮企业算一笔账:你到底要为不确定的流量,提前留多少冗余的成本,才能既不亏了用户,又不亏了钱包。这个问题,从来没有一键就能解决的魔法按钮。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:弹性伸缩:被云厂商吹了十年的技术,怎么还在让企业踩坑?
文章链接:https://www.lfdjt.com/info_23_25901.html
 大讲堂
