 大讲堂

被神化的技术边界:联邦学习从来不是「数据不出域」的万能解药
联邦学习的核心逻辑,从来不是「让数据动起来」,而是「让模型的参数动起来」。它的运作逻辑说穿了很简单:把原来集中在一个中心数据仓库里的模型训练流程,拆解到每个持有原始数据的机构节点上,每个节点先在本地用自己的私有数据算出模型的梯度参数,经过加密处理之后再传给协调方做全局聚合,整个过程里,原始的用户交易记录、医疗影像、消费行为数据,从来不会离开本地机构的服务器。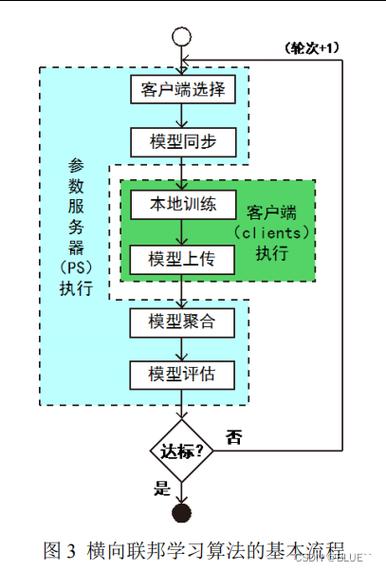
跑了6年的产业化:钱都花在了哪里,哪些坑是绕不开的
从2018年国内第一波隐私计算创业潮起来,算到现在已经快6年了。行业里的玩家从最开始的几十家创业公司,到现在互联网大厂、银行科技子公司、头部云厂商全部进场,市场规模看着涨得很快,但真正能从项目里拿到稳定收入的玩家,其实一只手数得过来。 现在真正跑通的落地场景其实很集中:第一类是金融领域的联合风控,也就是银行和运营商、合规电商平台之间的跨机构信用评估。某国有大行的技术团队之前对外分享过,和三大运营商用联邦学习做零售信贷的用户评分模型,在完全不接触运营商原始通话、缴费数据的前提下,把模型的风险区分度KS值提升了近10%——这个效果在银行的风控体系里,已经足够覆盖掉平台的搭建成本。第二类是医疗领域的多中心联合模型训练,之前每家三甲医院的癌症影像样本量都不够,训出来的模型换个医院的设备就准确率暴跌,现在用联邦学习把十几家医院的影像数据联合起来训练,泛化能力比单中心模型提升了至少30%。
被忽略的治理盲区:技术解决不了的信任问题,才是最大的风险
很多人对联邦学习的合规性有个天大的误解:觉得只要原始数据不出域,就不属于个人信息处理活动,完全不用过监管的合规要求。 真不是。 之前监管部门在公开的指导意见里明确提过,就算是用联邦学习传输加密参数,如果这些参数可以反推出具体的个人信息,那整个传输和训练的过程,依然属于个人信息处理活动,一样需要获得用户的明确授权,一样要履行个人信息保护的相关义务。现在很多机构根本没意识到这一点,以为套了个联邦学习的壳,就可以随便跨机构传数据,这其实是埋了很大的合规隐患。 还有两个行业内很少公开聊的风险:一个是合谋攻击,参与训练的几个节点如果串通起来,只要交换各自拿到的梯度参数,就能完整还原出其他节点持有的原始敏感数据;另一个是投毒攻击,只要有一个恶意节点往传输的参数里加针对性的干扰项,就能把整个全局模型带偏——比如在风控模型里,把有欺诈记录的用户评分拉到优质客户的区间,最后造成实打实的坏账损失。未来3-5年的判断:别神化,也别低估
别信那些说联邦学习会成为下一代AI通用基础设施的宣传。3到5年之内,它不会是一个普适性的技术,只会是一个强监管场景下的合规工具。 首先,它的落地会牢牢锁定在合规要求极高的领域:金融、医疗、政务。这些场景里,就算联邦学习的成本比集中训练高,机构也愿意为了规避合规风险买单,毕竟一笔监管罚单的成本,可能比搭三套联邦学习平台还贵。其次,行业标准会在未来两三年慢慢统一,现在已经有不少头部玩家开始推开放的跨平台联邦学习框架,未来跨厂商的对接成本会从现在的几个月降到几周,整个行业的项目交付效率会有质的提升。最后,它会和现在的行业大模型形成结合点——不用把各个机构的私有数据导出到公共平台,就可以在本地完成大模型的微调训练,这个场景的增量空间,可能比之前所有传统联邦学习项目加起来还大。 但也要清醒,联邦学习永远不会替代集中式的AI训练。毕竟集中训练的效率、成本优势摆在那里,它从来都是在合规要求和技术效率之间做的妥协,不是什么终极的技术方向。 上个月参加一个行业闭门会,碰到一个做了6年联邦学习的创业者,他说现在最大的感受是,前几年大家都在吹概念、算市场规模,现在终于开始沉下心来算单个项目的投入产出比了。 这其实是好事。 技术从来不是用来造神话的。能在具体的场景里,帮企业少踩合规的坑,帮用户的隐私少泄露一点,就已经够了。作者|大讲堂
排版|大讲堂
审核|见微