 大讲堂

上周跟做工业AI的老陈吃饭,他吐槽了半小时。说团队去年跟风把所有时序预测模型都换成了基于Transformer的时序大模型,跑了三个月,服务器账单涨了三倍,最后高炉异常预警的精度比2019年写的那套GRU代码高了1.7%。
就这。
他当场就把那套大模型流程切了,换回老代码。算下来一年能省近两百万的算力成本,预警延迟还降了两个数量级。
很多人现在提起循环神经网络(RNN),第一反应是”上一代淘汰的技术”。毕竟从2017年Transformer架构横空出世开始,技术叙事里的序列建模赛道,就好像成了注意力机制的专属地盘,谁还提RNN,谁就像拿着功能机跟智能机时代的人谈信号。
被叙事带偏的技术定位:RNN从来不是Transformer的”低配版”
真的是低配吗?
不见得。
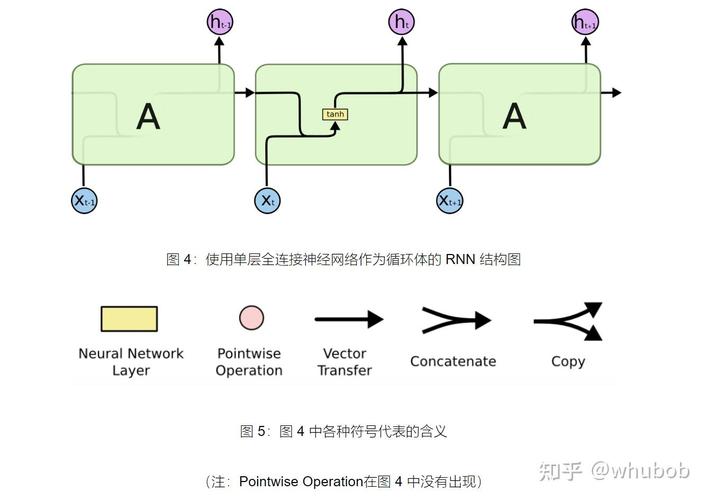
RNN的核心逻辑,从诞生那天起就跟Transformer走了完全不同的路。它没有什么全局注意力计算,就是把上一步的输出状态,塞回当前步的输入链路里,天然带着时间维度的记忆属性。最早的原始RNN确实有硬伤——序列拉得长一点,前面的信息就在梯度反向传播的过程中慢慢消失,跟人记不住上周二中午吃了什么差不多。
后来的LSTM、GRU变种,靠精巧的门控设计解决了这个问题:哪些信息要留,哪些信息要丢,哪些信息要输出,全靠三个门的阈值自己调控,不需要对整个序列做全局计算。
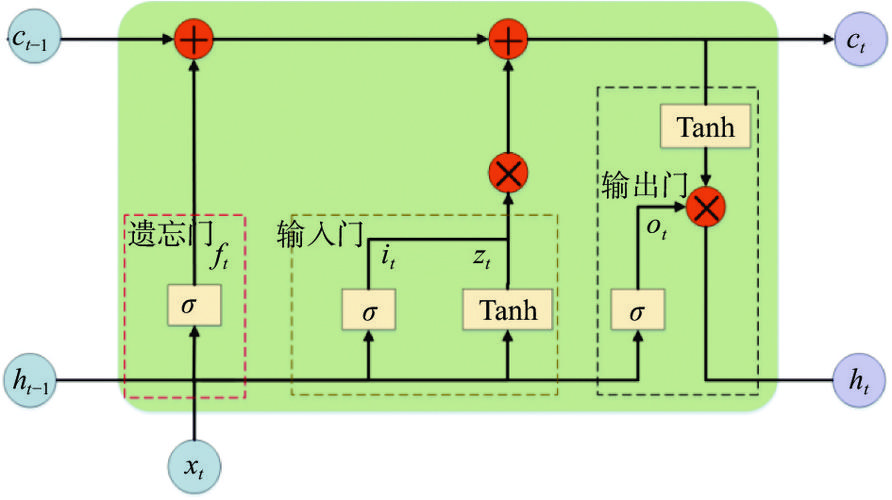
你现在每天用的手机输入法,最早那批能实现流畅联想的功能,根本不是什么云端大模型,是跑在端侧内存里的GRU模型。整个模型占的存储空间不到2M,按键响应延迟比云端大模型低两个数量级。
不过话说回来,技术圈的叙事向来走极端。一旦有新架构出来,老的东西就会被踩得一文不值。就好像当年卷积神经网络出来的时候,也有人说传统的图像处理方法会彻底消失,结果现在工业质检的场景里,大量简单的缺陷检测,还是靠传统方法加轻量CNN,成本低到可以忽略。
RNN也是一样。它从来不是为了在公开测试集上刷最高分设计的,是为了在有限的算力、有限的延迟要求下,把时序序列的建模任务做完设计的。
产业落地的真实账本:算力算不过来的地方,都是RNN的主场
很多人聊模型,张口就是测试集精度,闭口就是参数规模。
从来不算账。
就拿钢铁厂的高炉监测场景来说,传感器每秒会传回上百个维度的数值:温度、风压、矿石进料速度、冷却水流速。一旦出现异常,必须在几十毫秒内触发预警——晚一点,可能就是铁水泄漏、设备损坏的重大事故。
之前某厂的技术团队测过,同等精度要求下,基于Transformer的时序模型,单步推理的延迟是120ms,需要的GPU算力是单卡每小时近100元的成本。而优化过的GRU模型,单步推理延迟不到8ms,跑在普通的工业级CPU上就能运行,算力成本是Transformer方案的1/20。
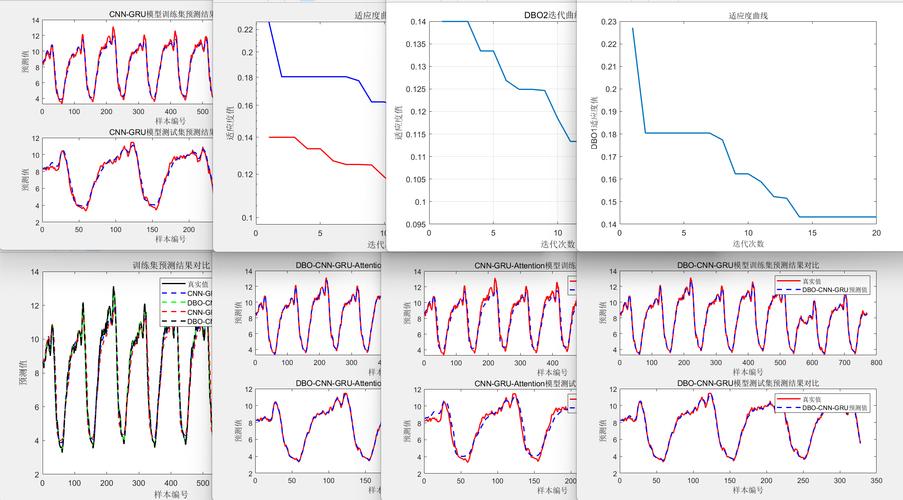
差多少精度?不到2%。
为了这2%的精度提升,多花20倍的钱,多担20倍的延迟风险,换你你干?
当然,RNN的优势场景远不止工业监测。比如电力系统的电网负荷预测,要连续几十年记录电网的用电时序数据,序列长度拉到几万步,Transformer的注意力计算量是随序列长度平方增长的,序列越长,算力成本涨得越快。但RNN是滚动更新状态的,每一步只需要把当前的输入和上一步的记忆状态做一次计算,根本不需要把所有历史数据都拉出来算一遍——长期运行的算力成本,会随着时间推移越拉越低。
更有意思的是,现在的RNN技术早就不是2014年那批老架构了。最近几年学术界出的线性循环单元、带状态压缩的RNN变种,把长序列的有效记忆长度从原来的几百步拉到了几万步,而且保留了线性的算力复杂度。说白了,原来RNN解决不了的超长序列问题,现在已经有了新的解法,根本不需要全靠Transformer来兜底。
被忽视的治理暗礁:隐式记忆的风险从来没有被拆透
很多人觉得RNN结构简单,好部署,就随便往生产环境扔。
这其实是个巨大的误区。
跟Transformer可以可视化追踪注意力权重不同,RNN的记忆是完全隐式的。模型把训练数据里的信息存在自己的循环状态里,你根本不知道它记了什么、记的东西对不对。之前有安全团队做过测试,用客服对话数据训练的LSTM模型,在生成自动回复的时候,会毫无征兆地吐出训练数据里存储的用户手机号、订单号——这些敏感信息根本没有被刻意放进训练标签里,是模型在记忆链路里”偷偷记住”的。
更头疼的是金融场景的应用。之前有个量化团队用LSTM做期货价格的趋势预测,模型在回测的时候表现特别好,结果实盘运行了三个月,遇到市场波动率突然抬升的行情,连续出现方向判断错误,一周亏了近两个亿。事后排查才发现,模型把训练数据里某段异常的行情波动,当成了通用的规律记在记忆状态里,根本没有区分特殊场景和通用规律——而这个问题,你根本没法靠简单的可视化排查出来,因为它的记忆是黑箱。
很多团队在部署RNN模型的时候,根本不做记忆链路的审计。觉得模型简单,不会出问题。
这跟开车不系安全带有什么区别?
未来3到5年,RNN根本不会从产业端消失,反而会在几个特定场景里,把被Transformer占走的份额慢慢抢回来。
第一个方向是端侧AI。现在所有人都在讲端侧大模型,但是端侧的算力、内存是有硬上限的。你不可能把几十亿参数的Transformer模型塞到智能手表、蓝牙耳机、工业传感器里,但是经过量化压缩的轻量RNN,参数规模可以压到几十万,就能实现实时的语音唤醒、运动状态识别、设备状态监测。这些场景里,Transformer的算力优势根本发挥不出来,RNN的轻量化特性是无解的。
第二个方向是超长时间序列的工业监测。比如风电叶片的结构健康监测,传感器是连续运行几年的,有效序列长度是几十万步。用Transformer做的话,每次推理都要把所有历史数据过一遍注意力计算,长期运行的成本高到离谱。但RNN是滚动更新记忆状态的,每一步只需要更新一次状态,不需要存储所有历史数据,长期运行的成本只有Transformer方案的零头。
第三个方向是跟大模型的深度融合。现在大模型的推理成本居高不下,很大一部分原因是每次生成长文本,都要把整个上下文窗口的内容过一遍注意力计算。其实完全可以把长期记忆的部分拆出来,用优化过的RNN做记忆状态的压缩,把历史对话的核心信息存在循环状态里,不需要每次都把所有历史内容过一遍注意力流程。按照现在的团队测试数据,这种融合方案能把大模型的推理成本降30%到40%,而且不会损失多少生成质量。
技术从来没有什么”先进”和”落后”的绝对划分。
适合场景的,能算得过来账的,能把风险兜住的,就是好技术。
别被那些非黑即白的叙事给带偏了。
作者|大讲堂
排版|大讲堂
审核|满满