 大讲堂

2026开年的集体踩坑:砸千万换的原生大模型,干不过捡回来的RAG
没人敢认账。
上个月国内头部消费电子品牌的内部复盘会泄露出来的截图在圈子里传了三天,没人好意思公开聊——这家公司去年年底刚咬着牙砸了2100万,把跑了三年的轻量RAG客服系统全拆了,换了个千亿参数的专属微调大模型,对外吹了半年”原生大模型驱动的全场景智能服务”。结果上线第七天,用户投诉率直接飙到18.2%。
有用户问2026款折叠屏的外屏防刮等级,模型张嘴就说达到IP69K防尘防水,实际上那款机型的外屏防刮等级只到IP54,连直接冲水都扛不住。还有用户问以旧换新的补贴规则,模型给的数字比实际政策高了40%,客服中心一天接了300多通投诉电话。算下来这一周的品牌损失,光赔付的优惠券就花了1200万,相当于给全国1200家线下门店的所有导购发整整一年的五险一金。
当初拍板换系统的技术VP在会上攥着报表半小时没说话——三个月前他刚在行业峰会上拿了年度最佳技术创新奖,获奖发言的核心就是”抛弃老旧RAG,走原生大模型路线才是未来”。最后还是CEO拍板,花了8万块钱找原来做RAG的外包团队,把三个月前删掉的代码从备份里捡回来,重新跑通。上线当天,客服投诉率直接掉回原来的2.1%,用户满意度比全参数微调的时候高了47个百分点。
说穿了,很多人从根上就对RAG有偏见。觉得这是”上不了台面的拼凑技术”——不就是把文档拆成块,存到向量数据库里,检索出来喂给大模型吗?哪比得上从零开始训个专属模型听起来高级。可没人算过账:你砸几千万训出来的模型,碰到新出的产品手册、新调整的售后政策,还是得重新微调,每次迭代要等一两周,成本够给RAG系统更新三年的内容。
被误解的RAG本质:不是万能解药,是和特种作战一样的成本逻辑
很多厂商现在还在吹”我们的RAG零幻觉”,纯纯扯淡。
你把上传的文档里的错别字都没清洗干净,检索回来的片段本身就是错的,大模型就算进化到能自己写论文了,也能顺着错的内容给你编出花来。真正能在生产环境跑通的RAG系统,根本不是靠多牛的大模型撑着——杭州那家做法律文书检索的创业公司,2024年的时候还在死磕向量数据库的召回精度,把Top3片段的召回率从85%硬卷到99.2%,结果跑了半年发现客户根本不买账。
为啥?贵。
原来的流程是,每一次用户输入的检索query,要先调云端的大模型做query改写,再做向量检索,再找另一个大模型做重排,最后把片段喂给大模型生成答案,单次检索的成本是0.12元。一个中型律所一天有2000次检索请求,光这部分的月成本就快赶上一个资深律师的工资了。最后团队咬着牙把原来的流程全拆了:不追求100%的召回精度了,把本地跑的7B小模型做初筛,把检索回来的Top100片段压到只剩Top1%的高相关内容,再喂给云端大模型生成答案。
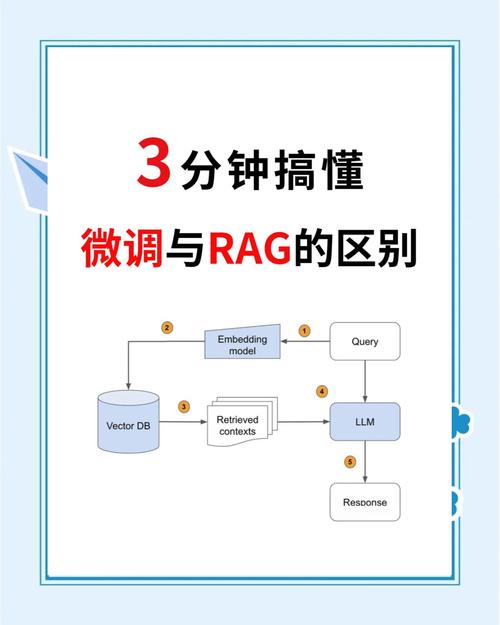
算下来,单次检索成本直接从0.12元降到0.008元,比原来便宜15倍,召回率只掉了3个百分点,客户根本感知不到。就这一个调整,他们的客户留存率从47%直接涨到89%,今年年初刚拿了红杉的A轮。
这里面的逻辑,其实和特种作战的战术一模一样。你根本不需要要求每个前线士兵能背下来整个战区的所有地形、敌情、装备参数——那是花几个亿训练出来的特种兵,也未必能记全的内容。真正高效的打法是,给每个侦察兵配个实时回传的情报终端,需要哪段情报,立刻从后方的数据库调过来,看完就用,用完就扔,根本不需要把整个情报库刻在士兵的长期记忆里。
说实话,我去年见过太多创业公司,拿着融资款就往大模型微调里砸,根本没算过账。这才是RAG真正的底层逻辑:它从来不是什么”让大模型不幻觉”的万能解药,本质是把大模型的”记忆成本”从一次性的训练投入,变成了按需调用的实时成本。那些天天喊着要做”通用大模型”的公司,其实就像非要训练一个能记住所有战场情报的超级士兵,成本高得离谱,还记不住最新的战场变化。
别被概念忽悠了:RAG才是普通从业者能摸到的真机会
卷不动了。
去年还在抢着做LoRA微调算法工程师的那群人,今年一半都转去做RAG调优了。为啥?原来你会个开源的微调框架,能把模型的准确率提5个点,开价就能到50万年薪。现在满大街都是会微调的人,简历投出去HR连回复都懒得回。反过来,那些能把RAG系统的检索延迟压到200ms以内、把业务场景下的幻觉率压到1%以下的工程师,现在企业开价直接到80万,还得抢着要。
这不是什么行业风口的变化,是所有做ToB生意的老板终于算明白账了。你是个开连锁药店的,原来想做个智能用药咨询系统,之前找外包报价要300万,说要训个专属的医疗大模型,现在人家给你报15万,用开源的RAG框架把你所有的药品说明书、医保目录、常见问答文档喂进去,一周就能上线,效果还比那个花300万训出来的烂模型好。你是个做职场培训的,原来想做个智能答疑系统,之前要花几十万把所有课程内容喂给大模型做微调,现在花几千块钱搭个RAG系统,每次新课程更新,直接把新的课件传进去就行,根本不需要重新训练模型。
说个真事。我楼下开图文打印店的老板,上个月花了800块钱,用开源的RAG框架把他攒了5年的所有印刷模板、报价单、老客户的特殊需求记录全给检索通了。现在客户在微信上发个模糊的需求,比如”上次给我做的那种带烫金logo的会议邀请函”,他10秒就能调出对应的模板和历史报价,比原来雇个熟手店员效率高3倍。他根本不知道什么叫向量数据库,什么叫chunk切分,只知道这东西比雇人划算,比之前花几万块钱买的所谓”智能客服系统”好用多了。
很多人觉得RAG是个过渡技术,等大模型的上下文窗口够大了,记忆能力够强了,RAG就会被淘汰。可没人算过另一笔账:就算以后大模型能一次读1000万字的上下文,你每一次调用都要把自己的商业机密文档全喂给云端的大模型,那成本得有多高?而且你自己的私有数据,怎么可能随便喂给第三方的大模型?
哦对了。
上次那个砍了RAG换全参数微调的消费电子品牌,这个月已经把全公司的智能系统全切回RAG架构了。你猜,当初在峰会上拿最佳创新奖的那个技术VP,现在在内部复盘会上,还能说得出”原生大模型是未来”这句话吗?
作者|大讲堂
排版|大讲堂
审核|柚子