 大讲堂

上个月杭州高架的梅雨季雨雾你还记得吧?浙牌的新势力车主群里炸了锅,某车企刚推送的端到端智驾V3版本,号称基于12万亿参数的跨模态预训练底座,能识别99.9%的道路静态与动态障碍,结果雨天压过湿滑路面上的共享电动车影子,直接触发全力急刹,后车差点追成铁饼。
一开始大家都骂,说算法写崩了,说工程师摸鱼了。
真的。我没夸张。我那个开Model Y的朋友,当时就在高架上被这个急刹晃了一下,现在一提这个新系统就骂街。
后来有技术博主拆了模型的微调样本库,才发现根本不是算法的问题——他们为了赶版本上线,喂给预训练底座的雨天道路视频总时长才127小时,还不如我家猫一周拆家的监控录像时长久。这点样本量,相当于让你背了一整本晴天考场的题库,到了雨天连试卷上的字都看不清,考砸不是应该的?
当时整个行业都在卷,谁家的预训练参数破20万亿,谁家的算力集群凑齐了一万张H100,谁家的训练速度能进全球前三,结果这个事爆出来之后,之前天天发通稿的几个厂商,集体闭麦了。我当时跟某头部大模型公司的预训练负责人在望京的小馆子吃烤串,他撸着串直接笑,说外面的人都被忽悠瘸了,以为预训练就是堆卡、堆参数、堆通稿,结果现在行业内部的共识是,只要你能把预训练数据集的脏数据率压到1%以下,就算你用3000张卡训出来的模型,效果能打别人1万张卡堆出来的八成。
算下来,去年某头部厂商清自己预训练数据集的人工成本,花了1200万,相当于把上海核心区一套100平的房子砸进去,就为了把数据里的水印、乱码、重复爬来的公众号文章、带版权的网文片段给抠干净。没人把这笔钱算进预训练的成本账单里,但它才是真正决定模型效果的核心。
被卷烂的预训练赛道,其实是个收过路费的生意
现在的预训练行业竞争,本质上跟二战时候的坦克战术没区别——大家铆着劲堆装甲厚度,把炮口直径越做越大,算力集群的机柜从一楼排到三楼,结果谁先摸透了穿甲弹的装药配方,谁就能绕开正面的硬刚,一炮打穿对面的参数神话。
说个真事。去年国内大模型圈有个挺出圈的事,百川智能没跟着大伙一起卷20万亿参数的通用大模型,反而转头扎进垂直领域,给医疗、法律行业做专属的预训练底座。当时一堆人骂,说王小川放着通用大模型的风口不追,守着小市场赚小钱,没格局。我当时还在朋友圈跟人打赌,说垂直预训练的路肯定能走通,结果今年看人家的营收,脸都被打肿了——人家根本不是走不通,是走得比通用模型的玩家顺太多了。
今年初,他们给北京某顶级三甲医院做的医疗预训练模型,诊断常见慢性病的准确率比通用大模型高了27%,API调用的收费是通用模型的3.2倍,现在排队要接入的客户从协和门口排到中关村。反观那些天天喊着要做全球通用大模型的厂商,现在API的价格已经卷到每百万token两毛钱,跟卖大白菜似的,算上电费、运维、机房成本,卖得越多亏得越多,连给员工发季度奖的钱都凑不出来。
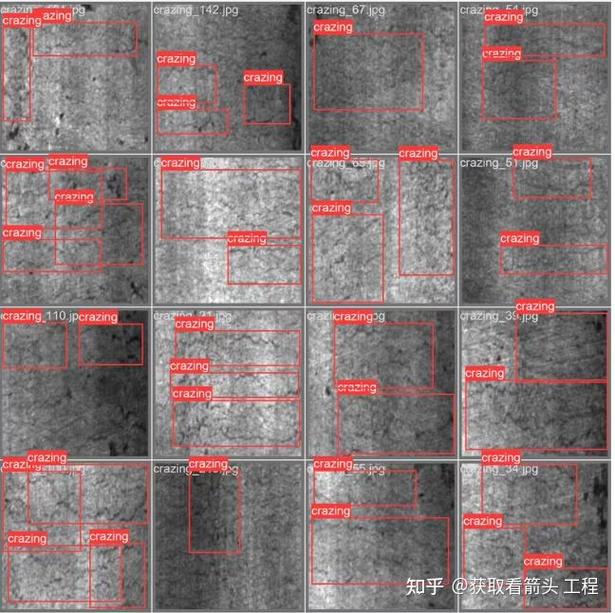
我之前跟一个做预训练数据标注的创业公司老板喝茶,他说现在行业里最赚钱的根本不是训模型的厂商,是给这些厂商卖干净数据集的。比如你想训一个能做工业质检的预训练模型,找他们买专门标注好的金属瑕疵样本,1TB的数据集开价80万,还不还价——毕竟你要是自己去攒样本,找工厂拍瑕疵照片,找师傅标注,花的钱比这多三倍,还耽误半年时间,等你训完,竞争对手早就把客户抢光了。
说白了,现在的预训练赛道,跟早年间的短视频赛道一模一样:大家都在抢流量、抢算力、抢参数规模,卷到最后,真正赚大钱的,是那些卖流量包、卖素材库、卖剪辑工具的人。那些拿着几亿融资就往算力机房砸的公司,现在回头看,钱花出去了,模型效果上不去,客户也不认,真的是卷不动了。
普通人在预训练浪潮里,根本不需要去挤GPU机房
很多刚毕业的计算机专业学生,一听说预训练火,就天天往学校的机房跑,跟着学长调分布式训练脚本,攒算力,想挤破头进头部大模型公司当算法工程师。结果去年某头部公司裁预训练团队的时候,第一批被优化的,就是那些只会调现成的训练框架,根本不知道训练数据从哪来、有什么坑的工程师。
别误会。不是说写代码的人不重要,是现在产业链上真正缺的,根本不是会写训练脚本的人。
缺的是什么?是能把各个行业里的零散经验,整理成干净、准确、没有版权纠纷的无风险训练数据集的人。
我去年认识的一个姑娘,之前是人民出版社的古籍编辑,干了7年,天天跟竖排的老书、过了版权期的旧期刊打交道。去年她辞职自己开了个10人小工作室,把市面上那些散落的老书、民国时期的旧杂志、建国初期的行业报告,整理成没有错字、没有水印、没有版权问题的干净文本,卖给做中文预训练的公司。上个月我跟她约咖啡,她刚把工作室从商住两用的loft搬到了带落地窗的文创园,说现在找她买数据集的公司,排到了下半年。
还有个之前在4S店干了9年的汽修师傅,平时没事就把自己遇到的各种汽车故障的排查流程、常见零件的损耗规律,整理成结构化的笔记。去年被一家做汽车售后预训练模型的公司找上门,开价20万买他三年攒的笔记,现在他干脆辞了4S店的工作,带着三个徒弟专门整理汽车维修的行业数据,赚的比当师傅的时候多三倍。
很多人觉得预训练是大厂的游戏,是拿着几千万上亿算力账单的人才能玩的资本游戏,普通人根本插不上手。其实根本不是。你在自己行业里摸爬滚打攒了十几年的经验,你手里那点别人没有的零散信息,就是预训练模型最缺的硬通货。毕竟现在大厂的模型已经卷到参数破30万亿了,再往上堆参数的边际收益已经快降到零了,真正能拉开效果差距的,就是那些别人没有的、垂直的、干净的行业数据。
等下一次行业通稿里吹出新的50万亿参数预训练模型的时候,你是那个蹲在机房里熬大夜调参数,等着被优化的工程师,还是那个坐在自己的小工作室里,把攒了多年的行业经验整理成数据集,等着大厂上门求你合作的人?
作者|大讲堂
排版|大讲堂
审核|阿辰