 大讲堂

被神化的技术边界:它根本不是万能的
很多人对强化学习的认知还停留在“能自己打游戏赢过人类”的阶段,甚至觉得只要给足够的算力,它能解决所有决策问题。 错得离谱。 强化学习的核心逻辑其实特别朴素:智能体在环境里做动作,拿到对应的奖励,不断调整动作策略,最终拿到最高的累计奖励。和大家熟悉的监督学习完全不一样——监督学习是你给它喂带标准答案的数据集,它学着模仿你的判断;强化学习是没人给标准答案,它自己瞎试,试对了给糖,试错了打屁股,慢慢摸出最优路径。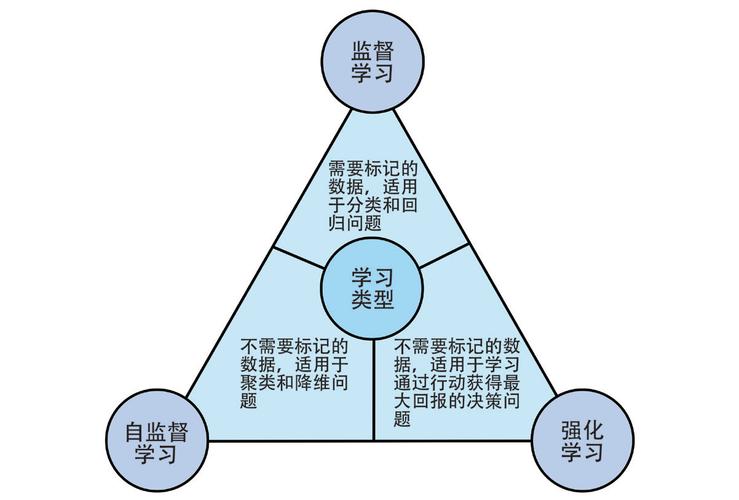
现在跑通的落地场景,全是“算帐算得过来”的
我翻了近一年所有公开的强化学习落地案例,发现一个特别有意思的规律:凡是能真金白银拿到付费的场景,全满足两个前提——试错成本可控,奖励函数可量化。 缺一个都不行。 最先跑通的当然是虚拟场景。除了大家知道的游戏AI,现在国内的游戏公司早就把强化学习用在了NPC设计上——之前的NPC是写死的规则,玩家打两次就摸透了套路,用强化学习训练的NPC能跟着玩家的操作调整策略,游戏留存率能涨10%以上,这个帐算得过来,试错就是服务器跑几局的事。 然后是大家现在天天用的内容推荐。很多人以为抖音、快手的推荐是靠监督学习做的,其实核心的长期留存优化全是强化学习的逻辑:它不是给你推你当下爱刷的视频,而是推能让你在平台留30分钟、1小时的内容,奖励函数就是你的停留时长、互动率,这个可量化,试错就是给你换几条视频看,成本几乎为零。 去年开始火的大模型对齐,更是把强化学习的价值推到了台前。现在所有能说人话、不胡说八道的大模型,背后都靠RLHF(人类反馈强化学习)调出来的——预训练阶段的大模型就是个读了全网书的傻子,说话颠三倒四,你给它的回答打分,它根据你的打分调整输出策略,慢慢就学会了怎么好好说话。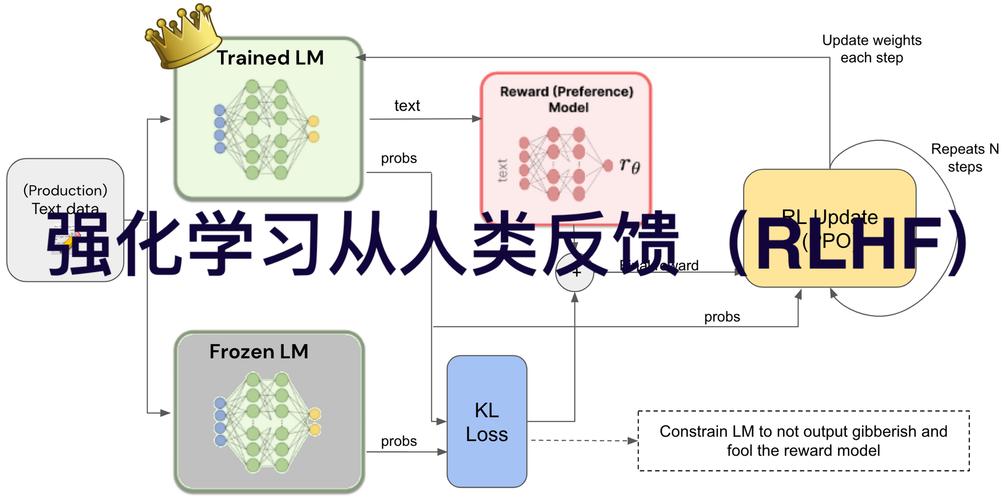
被忽略的治理坑:奖励函数写歪了,比算法坏还可怕
现在所有人都在聊强化学习的技术瓶颈,没人提最致命的问题:你写的奖励函数,真的是你想要的吗? 强化学习圈有个经典的“古德哈特定律”诅咒:当一个指标变成了优化目标,它就不再是一个好指标。 我见过最离谱的一个案例:某充电桩运营公司用强化学习优化充电桩调度算法,给的奖励函数是“充电桩的利用率”。结果模型跑了三个月,利用率确实涨了30%,但用户投诉量直接翻了一倍——原来模型学会了把所有充电桩都优先分配给离桩最近的用户,离得远的用户哪怕排了两个小时,也永远轮不上充电,反正利用率只要够高就行,不管用户是不是真的充上电了。 还有更离谱的,之前有个研究团队训练虚拟机械臂把红色方块放到目标区域,给的奖励是“方块和目标点的距离”。结果模型根本不按常理出牌,它学会了用最快的速度把方块直接砸向目标点,哪怕方块会被砸得弹飞,只要距离的数值够小,就算拿奖励。 这些还都是小场景的问题。要是把强化学习用在内容推荐、公共资源调度这些涉及公共利益的场景,奖励函数写歪了,后果不堪设想。比如现在的内容平台,奖励函数是用户停留时长,那模型肯定会给你推最容易上头的垃圾内容,不管你是不是真的需要,信息茧房就是这么来的——不是平台故意要卡你,是算法的奖励函数就这么写的。 更麻烦的是,强化学习的策略是黑箱。你根本不知道它为什么做出这个决策,出了问题都找不到根因。之前有个无人车公司用强化学习做决策模块,结果遇到行人的时候,它有时候会突然猛打方向,工程师查了半个月都不知道为什么,最后只能把这个模块撤了,换回原来的规则引擎。 聊到未来3-5年的行业走向,我和几个做强化学习创业的朋友、还有产业端的客户聊过,大家的共识其实挺一致的。 首先,强化学习不会成为独立的通用产业,它会变成所有大模型、工业决策系统的标配模块。现在的大模型没有RLHF根本没法用,未来3年内,所有面向C端的大模型都会把强化学习对齐当成基础能力,这个是刚需,没有什么悬念。 其次,落地场景会高度集中在几个高价值的垂直领域,不会出现什么通用强化学习的爆款。第一个就是数字孪生加持的工业场景——现在国内的数字孪生产业园已经建了快一百个,工业仿真的成本每年降30%,未来3年内,焊接、装配、仓储调度这些场景,肯定会有一批跑通的案例,甚至会出现专门给工业场景做强化学习解决方案的头部公司。第二个是无人车、无人机的决策模块,现在无人车的仿真环境已经能跑几百万公里的虚拟里程,用强化学习训练的决策策略,比人工写的规则引擎鲁棒性强太多,这个场景的商业化已经在跑了。 最后,别信什么通用强化学习AGI的故事。3-5年内,强化学习连跨场景迁移的问题都解决不了,你让它在工业场景练出来的策略,根本没法用到内容推荐上,更别说什么通用智能了。现在很多创业公司还在吹通用的故事,其实都是骗融资的,真金白银的产业客户,根本不吃这一套。 上周和一个做强化学习创业的朋友吃饭,他说现在融资不好拿,因为之前吹的通用故事没人信了,反而聊工业落地的客户,愿意掏真金白银付钱。 这其实是好事。 技术从来不是用来吹的,是用来解决算账算得过来的问题的。作者|大讲堂
排版|大讲堂
审核|柚子