 大讲堂

评论区炸了。
一堆技术博主跳出来拍胸脯,说这是模型参数不够大、雨天训练数据覆盖不足,只要堆到10万亿参数,补100万公里的极端天气路测数据,问题肯定能解决。
错了。
我当时看完视频的第一反应根本不是骂模型蠢,是替这家车企的财务部门捏了一把汗。当时那家车企公开的内部测算显示,这套端到端深度学习智驾系统的单公里推理成本是传统规则化智驾的37倍——算下来比同级别燃油车每公里的油费还贵2毛。暴雨天的传感器噪声是晴天的6倍,每帧画面的有效信息密度掉了70%,模型为了保证不出错,要反复做冗余推理,单公里的GPU消耗直接翻4倍。但凡财务那边卡一下算力配额,模型就会自动降精度跑,误刹、漏检的问题自然就冒出来了。
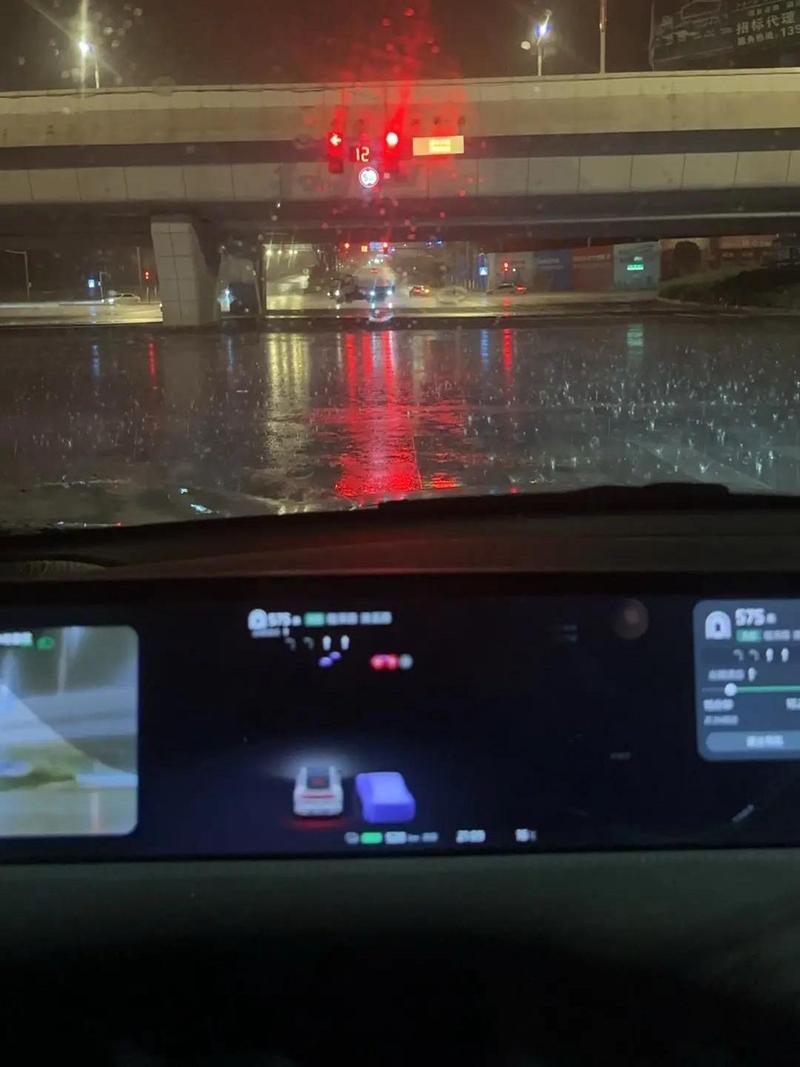
说白了,大家吵了半天“深度学习行不行”,根本没人提最实在的成本账——你花几千万搭的模型,跑一次的成本比用户掏的服务费还高,就算准确率做到100%,这生意也是亏的。
所谓的模型迭代,本质是算力和数据的零和博弈
很多人现在对深度学习的认知还停留在“参数越大越聪明”的阶段,根本没意识到这两年整个行业的博弈逻辑早就变了。
去年智谱AI的内部会上传出来一个细节:他们本来计划把通用模型从34B参数升到128B,算下来单次训练成本就要1.2亿,相当于公司整整6个月的营收。最后技术团队咬咬牙,砍掉了90%的通用互联网随机语料,换成了经过人工精标的垂直场景数据,最后模型的推理成本直接降了60%,面向企业端的服务准确率还涨了12%。
这事儿说穿了就像当年淮海战役的战场——国民党部队清一色美械装备,弹药足、火力猛,但是每打出去一发炮弹都要算着千里之外的补给线能不能跟上,最后被灵活穿插的解放军围着打。现在的深度学习圈就是这个德行:一堆创业团队拿着融资的钱硬堆GPU、堆参数,就像拿着美械装备的国民党部队,看起来阵仗吓人,但是现金流这条补给线根本撑不住,跑个两三年就弹尽粮绝。
有行业测算数据显示,现在国内团队训练一次70B参数的通用深度学习模型,消耗的电量相当于一个10万人口的县城全年居民生活用电。这还只是训练端的成本,真到了用户端推理的时候,成本还要翻几倍。
我见过太多团队把“参数规模”当成发布会的主打卖点,吹自己的模型是千亿级、万亿级,结果上线之后免费额度只有10次提问,多了就提示“请充值会员解锁更高额度”。这和20年前大家吐槽的“打印机卖得便宜,换个墨盒比打印机还贵”有啥区别?用户根本不是傻子,谁会为了一个摸不着的参数数字,多掏两倍的会员费?大家早就用脚投票,选那个响应快、成本低、准确率差不离的产品了。
别迷信大模型万能,普通从业者的活路根本不在堆参数
这两年校招季我总能碰到刚毕业的学生,挤破头去刷Transformer架构的题,去学怎么从零搭一个千亿参数的模型,觉得只要会调大模型参数就能拿年薪百万的offer。
真的想多了。
2026年春招我翻了某头部互联网公司的AI岗位招聘JD,127个AI相关岗位里,只有19个是做基础大模型训练的,剩下的108个岗位,全是做模型轻量化、垂直场景微调、推理成本优化的——说白了,根本没人需要你从零搭一个跑一次要花100块的模型,大家要的是你能把那个100块成本的模型,压到跑一次只要1块钱,还能保证准确率不掉。
我上个月碰到一个做汽车零部件工业质检的老工程师,去年他还跟我拍胸脯说,要把工厂里原来的小质检模型换成通用大模型,说什么“AI升级才能提质增效”。结果今年春天再见他,说项目直接被老板毙了——原来的小模型检一个零件的成本是2厘钱,换了大模型之后单零件成本是1毛2,工厂一年要多掏300万的算力钱,老板当场就把方案扔回他桌上。
说实话,我现在看到发布会上那些吹“我们模型参数又涨了多少”的厂商,就想起2015年的时候手机圈拼摄像头像素——从800万吹到1亿,最后用户发现,拍出来的夜景还不如当年苹果800万像素的清晰。硬件堆得再高,算法、成本、场景适配跟不上,全是白给。
现在整个产业链的风向早就变了。之前大家抢GPU订单,都是抢最贵的H100、A100,用来训模型。现在呢?国内做推理芯片的厂商最近订单接不过来——因为大家都想明白了,训练的时候用最贵的卡没问题,但是真正跑在用户端的时候,要的是便宜、省电、够用的推理芯片,谁能把推理成本打下来,谁才能拿到真金白银的订单。
那些天天喊着“要做中国的OpenAI”的团队,有几个真的算过自己账上的钱能撑几次全量训练?有几个真的算过用户愿意为自己的模型掏多少钱?
我倒要看看,当所有靠融资烧钱堆算力的团队把账上的钱烧完的那天,还有多少人会记得,深度学习本来是个帮人省钱的工具,不是用来撑场面的面子工程。
作者|大讲堂
排版|大讲堂
审核|乐乐