 大讲堂

上周跟长三角某汽车零部件厂的技术总监吃饭,他喝了半杯黄酒才吐槽——去年砸了两百万上的机器学习质检系统,现在还在吃灰。
当初对接的供应商拍着胸脯说,系统能识别98%的表面划痕、压痕、色差,替代三个质检工人,一年就能收回成本。结果上线才发现,车间的灯光早上和下午色温不一样,金属零件表面的反光角度随批次变化,模型的识别率直接掉到40%——连干了十年的老质检工一半的本事都没有。
说白了。机器学习从来不是什么魔法。
别被大模型营销绕晕:真实的技术边界在哪
很多人现在一提到机器学习,第一反应就是OpenAI的大模型,是能写代码、能画图的通用人工智能。真不是。
真正在国内产业场景里跑着的机器学习系统,90%以上都是传统算法树、异常检测、轻量视觉模型——根本不需要千亿级的参数,甚至连联网都不需要。
机器学习的核心逻辑简单到有点枯燥:拿历史输入和对应的结果,训练出一个误差最小的映射函数,让模型遇到新的输入时,能输出符合预期的结果。没有玄学。你给它喂全是良品的零件图片,它永远学不会怎么挑残次品;你给它喂格式混乱的病历文本,它输出的诊断建议能错得离谱。
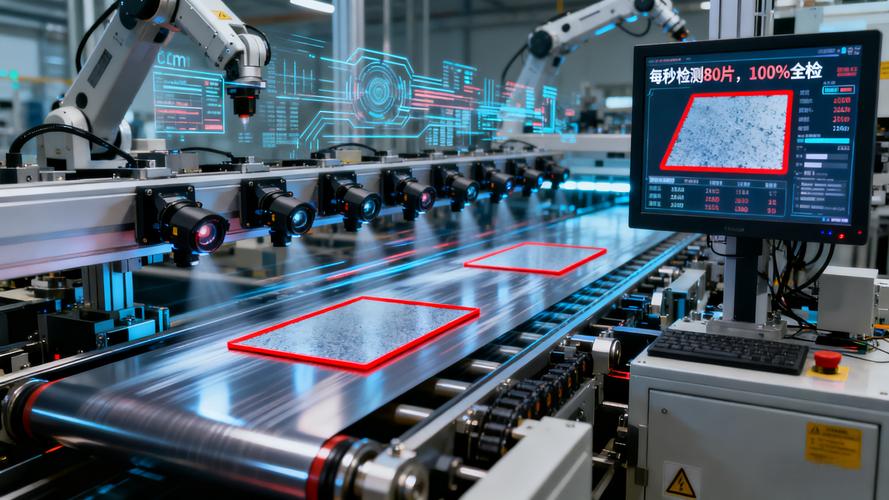
刚才那个零部件厂的问题,本质就是训练数据的覆盖度不够。供应商当初为了快速交付,拿网上找的通用金属零件缺陷数据集微调了模型,根本没花时间去收集客户车间里不同灯光、不同批次、不同角度的真实样本。这种系统上线能用才怪。
说实话,很多人对机器学习的预期被大模型的营销吹得太高了。觉得只要上了系统,就能自动解决所有问题。但实际上,机器学习的技术边界非常清晰:它只能解决那些历史上有明确数据记录、判断逻辑相对固定的重复性问题。让它去判断一个复杂的供应链决策,或者需要结合行业经验的模糊判断,它根本做不到。
产业链的隐形分层:谁在赚钱,谁在交学费
现在整个机器学习产业链的分层,跟媒体上写的完全不一样。
最顶层的当然是做通用大模型的公司,拿着亿级的融资,天天开发布会,上热搜。但真正闷声赚钱的,是那些藏在垂直场景里的小团队。
我接触过一个专门做光伏板缺陷检测的创业团队,一共才12个人,没有什么公开的融资新闻,一年做三千多万的营收,毛利能到65%。他们的客户都是国内的光伏组件厂,算过账:上一套他们的边缘端检测系统,能替代80%的人工质检环节,一年省下来的人力成本就有两百多万,不到一年就能收回系统投入。
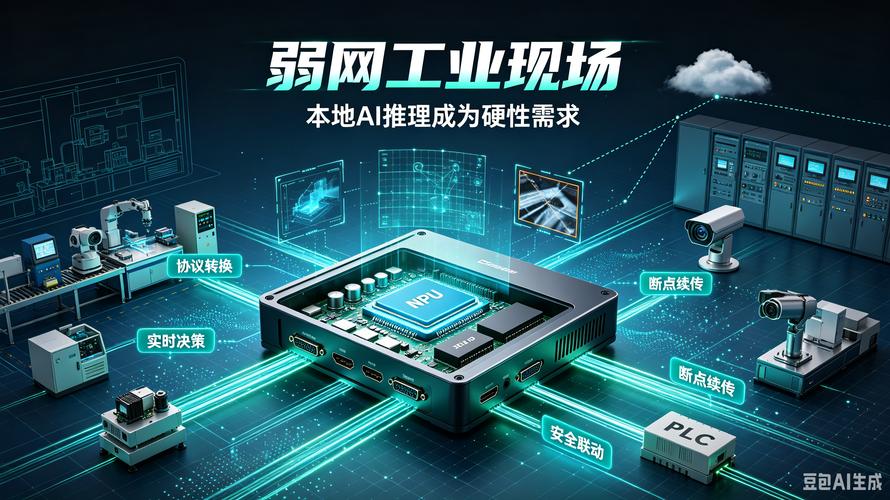
为啥他们能赚钱?因为根本不搞什么花里胡哨的通用模型,就是扎在光伏这个场景里,攒了几百万张不同缺陷类型的光伏板样本,把模型压到了百兆大小,直接装在车间的边缘盒子上,不需要联网,延迟能到8毫秒。
反过来,那些砸了几个亿做通用大模型,拍胸脯说要给所有行业做解决方案的公司,反而很多在烧钱。为啥?因为他们根本不懂垂直场景的真实痛点。比如给服装厂做布料缺陷检测,你得考虑不同颜色、不同材质的布料反光差异,得考虑车间里的飞絮对相机成像的影响,这些细节根本不是靠通用模型能解决的。
不过话说回来,交学费的也不全是创业公司。很多传统企业老板,被供应商的PPT忽悠,觉得上机器学习系统就是赶潮流,不管自己的场景是不是真的适合,先砸钱上了再说。最后系统建好了,没人用,数据也没人维护,几百万的投入直接打了水漂。
绕不开的三重墙:数据、算力和伦理
现在机器学习落地遇到的最大障碍,根本不是算法不够先进。
第一堵墙是数据。真正的落地成本,70%都花在数据清洗和场景适配环节。很多行业的私有数据根本没有标准化的格式——比如医院的病历,不同科室的医生写的术语不一样,检查报告的格式乱七八糟,你要拿这个训练模型,光把数据整理成能喂给模型的格式,就得花好几个月的时间。很多公司为了省事,直接拿公开的通用数据集微调,最后出来的模型根本适配不了本地的真实场景。
第二堵墙是算力的错配。很多人觉得机器学习就需要买最贵的GPU集群,就得把所有数据传到云端计算。但实际上,90%的工业场景根本不需要这么重的算力。车间里很多角落连稳定的手机信号都没有,你把数据传到云端,光网络延迟就能把整个系统的体验搞崩。用个巴掌大的边缘推理盒子,跑个轻量模型,成本只有云端集群的十分之一,可靠性还高得多。
第三堵墙是伦理和组织的阻力。我之前接触过一个电子厂,上了一套机器学习的员工效率监控系统,能通过摄像头识别工人有没有走神,有没有长时间离开工位,甚至能算出来每个人的操作动作是不是符合标准。结果上线三个月,车间走了20%的老工人,算下来的招聘成本、培训成本,比系统省下来的那点人力成本高了两倍都不止。
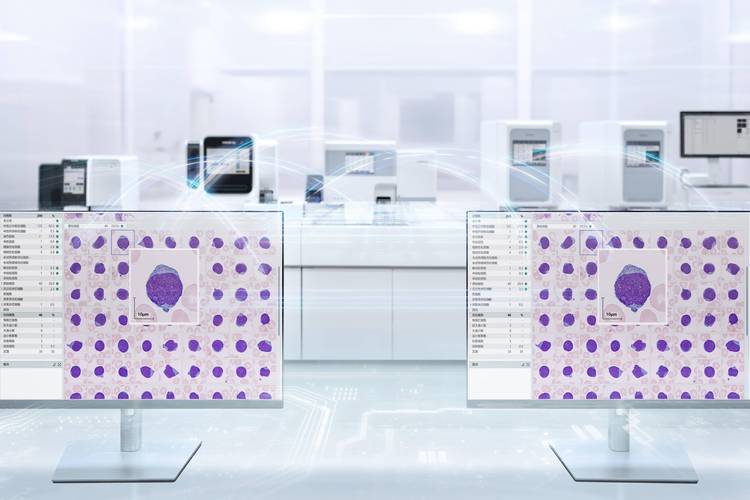
更别说现在越来越多的场景里,机器学习的决策是黑箱——比如医院里的辅助诊断模型给了一个判断,你问它为啥是这个结果,它根本说不出来。这种系统在医疗、金融、司法这些高风险场景里,根本不敢直接落地。
未来3-5年的判断:没有万能系统,只有场景深耕
很多人预测未来会出现一个通用的机器学习系统,能搞定所有行业的问题。我觉得根本不可能。
未来3到5年,机器学习的发展方向一定是越来越细分,越来越垂直。不会有什么能同时搞定工业质检、医疗诊断、零售库存预测的万能模型。反而会是一堆小而专的模型,每个模型只在自己的细分场景里做到99%以上的准确率——比如给服装工厂做缝边检测的,给电网做线路绝缘子缺陷识别的,给连锁药店做库存预测的。
还有,未来的核心竞争壁垒,根本不是谁的模型参数多,谁的GPU集群规模大。真正的壁垒,是你能不能拿到别人拿不到的行业私有数据。比如你跟一家三甲医院合作了五年,攒了十万份标准化的病理切片数据,那你在病理辅助诊断这个赛道的护城河,比你有一千张A100显卡都高。
别被那些“机器学习要替代所有人工”的吓唬人的话骗了。它就是个工具。跟当年的数控机床、ERP系统一样,本质上是帮人把那些重复、枯燥、容易出错的活接过去,让人去干更需要判断力、更有创造性的事。对吧?
作者|大讲堂
排版|大讲堂
审核|安然