2026-10-02 15:26:17 作者:大讲堂
你每天刷脸进小区,扫码付奶茶钱,路过商场门口的智能摄像头还会被推送优惠券。你会不会已经觉得,计算机视觉早就实现了——机器早就看懂这个世界了对吧?
说实话,我之前也这么想。直到上个月跟一位做CV算法的老朋友吃饭,他吐了一晚上苦水,我才回过神来。我们看到的都是包装好的成功案例,底下藏着一堆没人说的烂摊子。
别被刷屏案例骗了,计算机视觉的本质从来没变过
很多人说深度学习革命改变了CV,这话不对。从1960年代的边缘检测,到今天的千亿参数多模态大模型,计算机视觉的核心逻辑从来都是“找特征,做匹配”,它从来没有真的”理解”过图像内容。
你给它看一万张猫的照片,它能总结出猫的像素分布规律,下次碰到符合这个规律的图像,就输出”这是猫”的结果。但它不知道猫是一种会叫会跑的动物,也分不清把猫毛P成狗毛的图片到底是什么。
这就是它天生的技术边界。
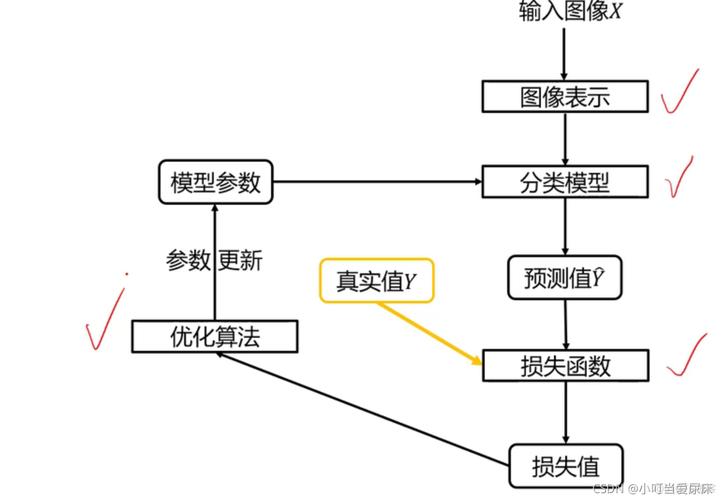 计算机视觉深度学习目标检测流程示意图
现在火得一塌糊涂的多模态大模型,也没突破这个边界。OpenAI的GPT-4能看懂图片里的笑话,本质还是训练数据里见过类似的图文组合,换一个没见过的手绘示意图,它立马就错。之前有人做过测试,把香蕉换成蓝色,GPT-4有超过一半的概率认不出来这是香蕉。
对抗样本的问题到现在也没解决。只需要在路牌上贴几个不起眼的小贴纸,就能让自动驾驶的CV系统把”停止”认成”限速”。这放在任何民用场景都是要命的风险。
产业落地的真相:赚钱的生意,都躲着”通用视觉”走
你去翻国内头部CV公司的财报,前几年炒得沸沸扬扬的自动驾驶、通用AI视觉,占营收的比例不到10%。90%以上的赚钱项目,都集中在背景固定、目标有限的封闭场景。
说白了就是做”窄而深”的定制化,不碰”宽而广”的通用梦。
最典型的就是工业缺陷检测。现在国内汽车、电子生产线已经铺了几十万套CV检测设备,准确率能做到99.9%以上。为什么能成?因为场景完全固定:生产线速度固定,产品位置固定,缺陷类型就那十几种。算法只需要针对这几种缺陷训练,不需要管别的。
换到开放场景呢?比如让CV去大街上数流浪猫的数量,别说现在,再过五年也做不到。同一个角度,树荫挡住一半,换只毛色奇怪的猫,算法直接就漏检了。
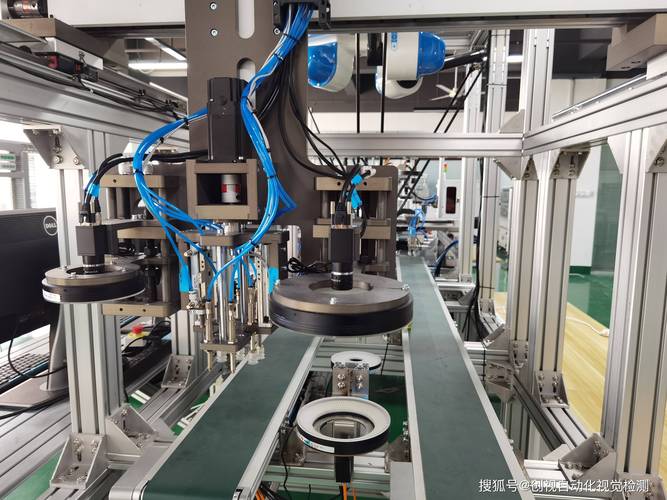 工业生产线计算机视觉缺陷检测实景图
不过话说回来,就算是封闭场景,落地的坑也不少。很多地方政府花大价钱建的智慧安防摄像头,号称能识别未戴口罩、聚众吸烟,实际准确率不到60%,大部分时间都是误报,最后沦为摆设。为什么?因为场景看起来封闭,实际变量太多——今天刮沙尘暴,明天起大雾,冬天树上叶子掉光,夏天又长满,这些变量算法没见过,就不行。
还有数据的坑。标注1万张通用图片的成本现在已经过万,复杂场景比如医学影像,标注一张就要几十块。很多中小厂家根本承受不起,就算做出来,换个产品线就得重新标注重新训练,成本比雇三个老工人还高,谁愿意用?
未来三年:洗牌之后,机会在哪,风险在哪
 未来三年:洗牌之后,机会在哪,风险在哪
现在CV赛道早就过了靠故事融资的阶段,一级市场投CV的钱比五年前少了一半还多,一堆小公司倒闭,剩下的头部公司也在往垂直场景转。
未来三五年,我敢说,通用计算机视觉还是出不了能赚钱的大规模商业化产品,机会全在垂直闭环。
第一个机会是和实体机器人结合。现在移动机器人、工业机械臂缺的就是靠谱的视觉导航、视觉抓取,只要能在某个细分场景比如仓储拣货、果园采摘把准确率做上去,稳定运行,不愁没订单。第二个机会是多模态大模型落地的视觉入口,现在大模型要落地到行业,很多场景都需要图像输入,比如装修设计师让大模型改设计图,医生让大模型读CT片,CV就是绕不开的基础能力。
但风险也很明显,首当其冲的就是伦理和合规。这两年全球各地都在出法规管人脸数据,欧盟的AI法案把公共场合生物识别分类成高风险AI,管得极严,国内也出台了个人信息保护法,随便采集人脸数据就是违法。之前很多靠人脸项目活着的中小公司,现在已经没生意做了。
其次就是深度伪造的风险,现在换脸技术能做到普通人根本分不出真假,造谣、诈骗的成本越来越低,最近已经出现不少用深度伪造换脸骗企业老板转钱的案例,技术越先进,这个漏洞越大,怎么监管怎么技术防范,到现在还没找到成熟的方案。
说句实在话,别动不动就吹机器要超越人类视觉了。人类眼睛和大脑处理图像的能力,进化了几百万年,计算机视觉才发展不到七十年。我们现在才刚摸到门槛,路还长着呢。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:计算机视觉:正在拆穿"机器看懂世界"的美丽谎言
文章链接:https://www.lfdjt.com/info_23_23624.html
 大讲堂
