2026-10-02 05:19:52 作者:大讲堂
当Transformer刷遍所有NLP榜单,大模型成为科技圈唯一的热点,很多人已经记不起LSTM这个名字了。
真的是这样吗?
LSTM真的是被业界低估太久了!
很多人把LSTM当成了上个时代的淘汰技术,扔进了教科书的角落。但如果你走到产业落地一线看一看,就会发现完全不是这么回事。
说实话,我见过太多创业团队,上来就要搭千亿参数的Transformer大模型,结果几十万的落地预算,连推理成本都覆盖不住,最后回头捡LSTM,反而交了合格的项目交付。
被梯度消失困住的老RNN,逼出了LSTM
序列问题,从人工智能萌芽开始,就是最难啃的骨头之一。
语音、文本、传感器数据、股价波动……所有带时间顺序的数据,都需要模型能记住之前的信息,解决长距离依赖问题。
最早的循环神经网络RNN,思路很简单:每一步都把上一步的信息带着走。理想很丰满,现实一训练就崩。因为反向传播的时候,梯度会随着序列长度指数衰减,前面的信息传个几十步就没了——这就是行业人尽皆知的梯度消失问题。
举个最简单的例子:“我出生在法国……我会说一口流利的____”。空里要填“法语”,但隔着几十个词,老RNN早就把前面“法国”这个信息忘干净了。
九十年代中期,学界试了无数办法都搞不定这个死结,直到1997年Schmidhuber和Hochreiter拿出了LSTM。
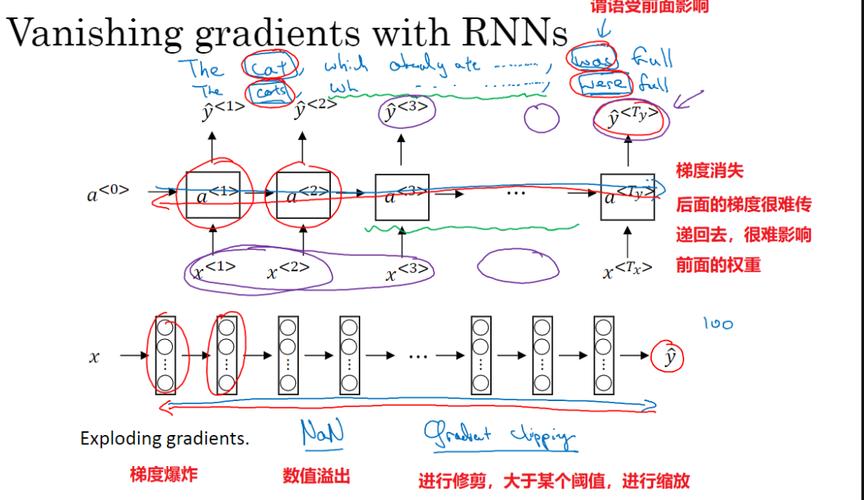 传统循环神经网络梯度消失示意图
这个设计放了十几年没人用,那时候算力不够,普通的序列任务老RNN凑活能用,没人愿意折腾新架构。直到2010年之后大数据爆发,语音识别、机器翻译的需求起来,大家才发现LSTM是真的好用,直接把整个序列任务的效果提了一个大台阶。
三道门:看似复杂实则聪明的设计
很多人讲LSTM的原理,一堆公式堆上来,把新手吓跑了。说白了,LSTM就是给RNN加了三道阀门,专门管信息的留和忘,核心思路其实非常符合人类的记忆逻辑。
核心是那个“细胞状态”,相当于模型的长记忆本。然后三个门:遗忘门、输入门、输出门。
最关键的就是遗忘门——原来的RNN是不管有用没用全往脑子里塞,越装越乱,最后什么都记不清。LSTM是主动扔掉没用的旧信息,只留关键信息。比如刚才那句法国的例子,前面讲了当天天气、吃了什么饭这些无关信息,直接扔掉,只留“出生在法国”这个关键信息,需要用的时候随时能调出来。
输入门管把新的关键信息加进记忆本,输出门管把当前步骤需要的信息拿出来用。
就这么简单的设计,直接把困扰学界几十年的长序列记忆问题解决了。原来RNN搞不定的几十上百步的依赖,LSTM轻轻松松就能记住。
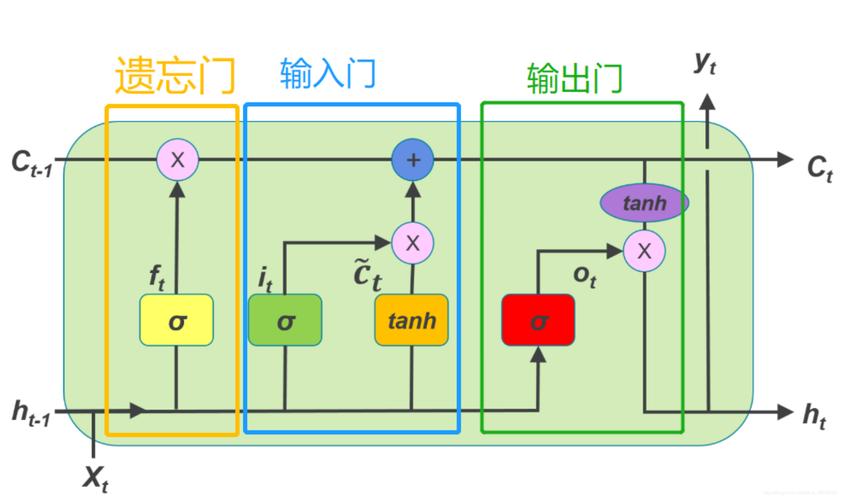 LSTM三门结构原理示意图
不过话说回来,LSTM也不是完美的。它天生就不好做并行训练,序列太长的时候训练速度比Transformer慢很多,极限长序列的表现还是不如Transformer。这也是后来Transformer起来之后,LSTM退居幕后的核心原因。
Transformer时代,LSTM的产业位置在哪里?
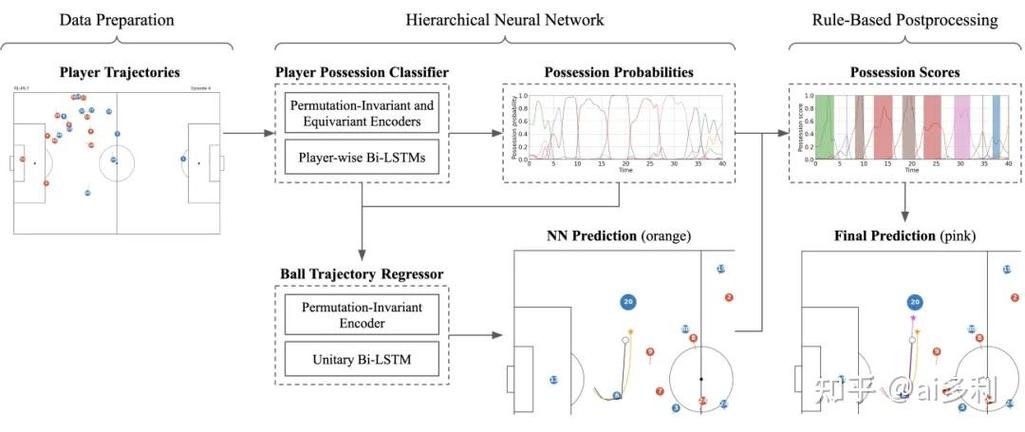 Transformer时代,LSTM的产业位置在哪里?
现在业内有一种错觉,觉得LSTM已经被Transformer彻底淘汰了。实际上,LSTM每年的落地项目数量,可能比中小参数Transformer还多。
为什么?核心就是两个字:便宜。
LSTM的参数量很小,做一个工业设备故障预测模型,几万几十万参数就够了,跑在一块几块钱的MCU上都能流畅推理。反观Transformer,哪怕是小参数的BERT-base,也得有上百M的参数量,端侧部署根本玩不起,推理一次的电费都能吃掉大半个项目利润。
现在哪些场景最依赖LSTM?
第一是工业物联网的时序预测。工厂的传感器每秒都出数据,要预测设备异常故障,都是典型的序列任务,LSTM在边缘控制器上直接跑,不需要上传云端,延迟低,成本还低,还不用担心数据隐私泄露,比把数据传去云端跑Transformer划算太多。国内不少做工业预测维护的公司,核心模型还是LSTM,换Transformer根本赚不到钱。
第二是端侧的输入法、语音助手。你手机上输入法的下一词预测,很多还是用LSTM做的,本地就能算,反应快,还不费电,没人会把下一词预测放在云端大模型上做,那延迟体验能把用户逼疯。
第三是中小体量的金融时序预测。高频交易里做短期价格预测,很多团队还是用LSTM,因为数据量不算特别大,LSTM不容易过拟合,可解释性也比黑箱Transformer好一点,出了问题好回溯排查。
当然,LSTM也有绕不开的瓶颈。面对几千步以上的超长序列,还是会出记忆衰退,训练并行度上不去,大数据量下的表现确实不如Transformer。
还有一个很现实的问题:现在太多年轻从业者做AI,只学Transformer和大模型,根本没好好了解过LSTM,导致很多明明适合LSTM的低算力场景,硬上大模型,最后钱花了一堆,效果还不如小LSTM模型。这不是技术进步,这是资源浪费。
未来3到5年,我对LSTM的判断很清晰:它不会被Transformer彻底取代,反而会下沉到AI产业的更底层。
随着边缘AI的爆发,越来越多的端侧智能设备需要低功耗的序列处理能力,LSTM天生适合这个场景,需求只会涨不会跌。其次,会有越来越多的混合架构出现:用LSTM做端侧的前置序列预处理,把筛选后的关键信息传给云端的Transformer大模型做推理,既省了带宽,又降了成本,两全其美。
它不会再站在AI浪潮的C位,成为聚光灯下的宠儿。但它会一直待在产业的毛细血管里,默默扛着绝大多数细分场景的序列处理需求。不起眼,但是缺了它,很多机器真的转不动。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:LSTM:被Transformer掩盖的序列之王,为什么至今仍是产业落地的中流砥柱
文章链接:https://www.lfdjt.com/info_23_23555.html
 大讲堂
