2026-10-02 00:49:07 作者:大讲堂
最近跑了十几家和ML相关的创业公司,有做大模型的,也有做传统工业ML解决方案的,反差大到离谱。一边是融了上亿美元的团队在写字楼里天天讨论怎么蹭热点拿下一轮,一边是蹲在工厂地下室里调参数的团队,拿着几百万订单愁数据不够用。
被过度包装的ML:核心逻辑到底是什么
很多人一提ML就自动等同于ChatGPT,等同于通用人工智能。不对。ML全称机器学习,本质就是这么一回事:不用人类给机器写死每一条规则,让机器自己从海量数据里找出统计规律,再用这个规律去预测或者生成新内容。
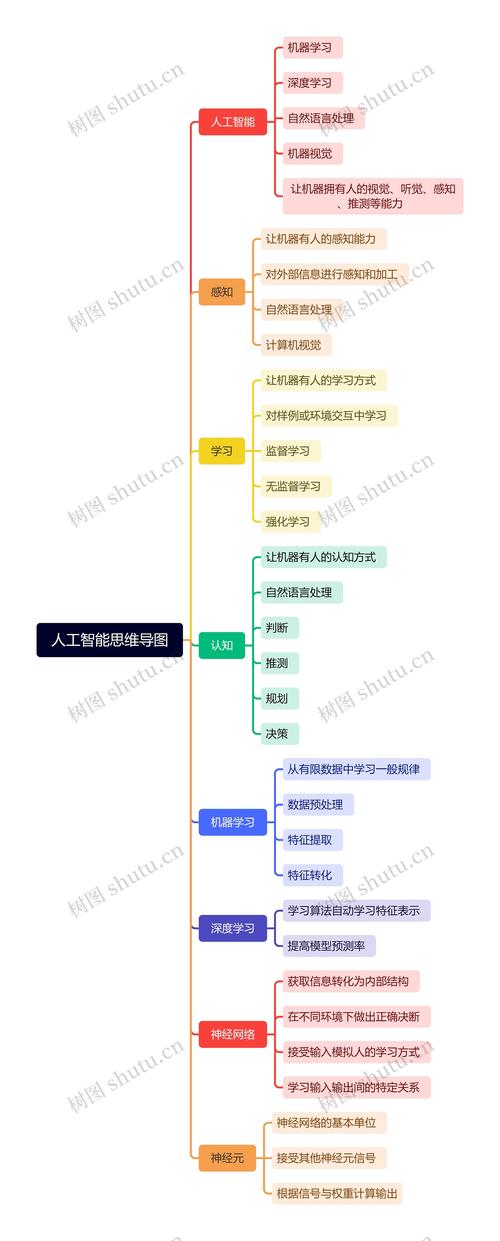 人工智能领域ML分支关系图
这是ML和上一代规则式AI最核心的区别。原来的AI要识别一个苹果,你得给它写清楚“红色、圆形、直径多少厘米”,碰到个绿苹果就瞎了。ML呢?你给它喂几万张不同颜色不同大小的苹果照片,它自己就能总结出苹果的特征,再来新的苹果,认对的概率比人还高。
听起来很美好对不对?但这里有个天生的缺陷:ML所有的能力都来自喂给它的数据。数据不对,再多算力都是白搭。说实话,现在90%的ML项目死在这里,不是算法不够先进,是数据从根上就错了。
产业落地的冷热:哪才是ML的真应用场景
ML其实早就渗透进你我的日常生活了。你刷抖音刷到停不下来,点外卖半小时就能送到,手机解锁能认出你的脸,这些全是ML在干活。这些场景成熟了,为什么?因为有源源不断的标准化数据,用户点不点这个视频,买不买这个商品,点完就给模型反馈了,数据循环跑通了,自然越用越好。
不过话说回来,to C跑通,不代表to B就能轻松复制。我上个月跟着一个做工业预测性维护的团队去苏南的一个化工厂,他们要给压缩机做ML故障预测,说白了就是提前一周告诉工程师机器要坏了,赶紧停,别出事故。
结果呢?工厂跑了二十年,坏过的压缩机一共才不到十次,攒出来的坏机器数据还不如大模型一张图的像素多。ML根本没法学。最后凑出来的模型,误报率超过60%,工程师天天跑过去看假故障,比不用还麻烦。
 工厂工业机器学习预测性维护部署现场图
落地障碍从来不是算法,是产业本身。很多传统企业连基础的数据采集都没做好,设备上的传感器十年没换过,出来的数据一半是噪声,给ML喂垃圾,出来的当然是垃圾。还有更深层的问题:ML要优化流程,必然动既得利益。原来管设备的老师傅,话语权来自几十年的经验,你上个ML系统说能代替他判断,人家凭什么帮你做数据标注?
数据缺,标准乱,利益阻,这三个问题,拦住了至少八成传统行业的ML落地。现在好多创业公司喊着“用AI赋能传统行业”,本质就是拿ML当幌子拿项目,最后交付个demo就完事,根本用不起来。
未来3-5年:ML的泡沫会破,价值会显
 未来3-5年:ML的泡沫会破,价值会显
现在这波ML热,是从2022年底ChatGPT出来之后炒起来的,资本疯狂砸钱,到处都是“通用AI”“AGI即将到来”的喊声。我就说一句:太虚了。
参数竞赛已经走到头了。万亿参数模型的性能提升,早就边际效益递减了,花十倍的钱,性能提升不到10%,给谁用都用不起。接下来,垂直领域小模型才是真的机会。针对某一个行业,某一个具体场景,用百万级千万级参数训练,数据都是垂直领域打磨过的,部署成本只有大模型的百分之一,效果比通用大模型还好。
风险也摆在那。ML的统计本质,决定了它一定会犯错。现在很多金融领域用ML做风控,偶尔出一次错,就是几百万的损失。医疗领域用ML读片,漏诊一次就是人命关天。谁来担这个责任?现在还说不清楚。还有数据偏见和隐私的问题,训练数据里藏着的性别歧视、地域歧视,模型学了去,出了问题谁来改?这些治理问题,未来3-5年必须拿出解决方案,不然ML根本没法在核心领域落地。
未来3-5年,不会出现科幻电影里那种取代人类的通用ML。大部分产业里,ML就是个效率工具。帮你把重复的活干了,帮你从一堆数据里挖出人找不到的规律,仅此而已。
泡沫破了。剩下的,才是真正能赚钱,能改变产业的东西。ML不是万能药,治不了所有产业病,找对自己的位置,比什么都重要。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:ML不是万能药:产业落地的真相与未来边界
文章链接:https://www.lfdjt.com/info_23_23503.html
 大讲堂
