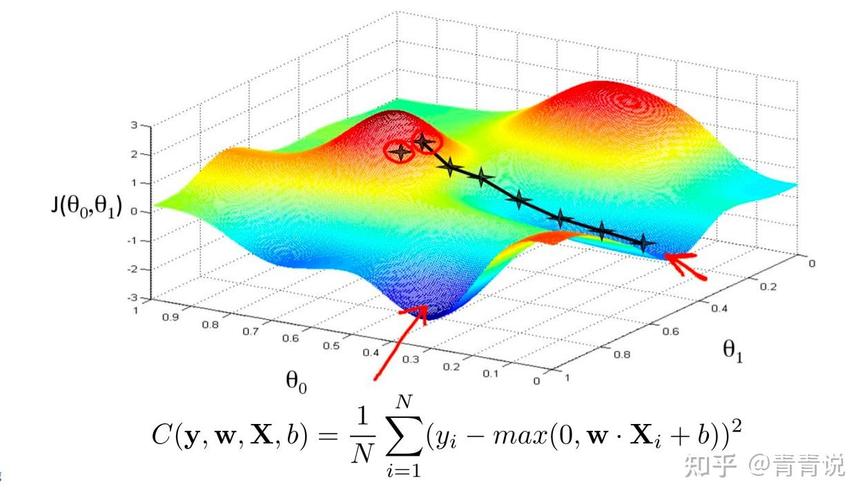
梯度下降的本质是回归最朴素的直觉:以最小化损失为目标,沿着坡度最陡的方向迈步。数学上,θ_t+1 = θ_t – η·∇L(θ_t)。但工程实现并没有那么线性。学习率 η 太大会震荡,太小则爬不出来。于是有了 Adam,它给每个参数配了自适应步长,还加入动量项。相当于你多了一根手杖,并且能感知到上次迈步的惯性。
但 Adam 不是银弹。在 ImageNet 上用 ResNet-50 训练,公开 benchmark 中,SGD 配合 cosine 退火能达到 76.3% top-1 准确率,而 Adam 的默认配置只有 74.9%。有意思的是,Adam 在头 30 个 epoch 内收敛速度明显更快,导致很多人误以为它全面胜出。经验做法是:前半程用 Adam 加速,后半程切 SGD 微调。这就像手动挡,起步用一档,上了高速换五档。
梯度下降损失函数三维曲面示意图
二、反向传播:误差的逆流
二、反向传播:误差的逆流
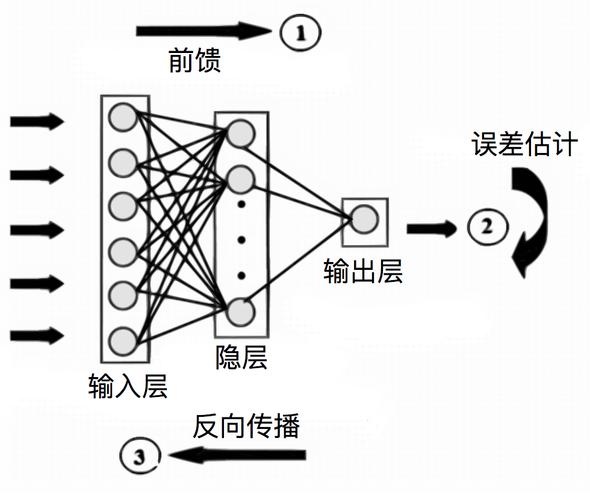
如果梯度下降是下山的步法,那反向传播就是计算步法方向的机制。它利用链式求导,把输出端的误差一层层传回去,每一层只更新自己的参数。这个过程的计算量只是前向传播的两倍以内,和参数数量呈线性关系。没有它,深度网络只能靠随机搜索,那基本是宇宙热寂级别的效率。
搞通了这两个概念,你才算入了门。但现实是,很多人直接跳到炼丹,连 loss 每次下降的原理都不明白,最后模型崩了都不知道从哪debug。
 大讲堂