我随口站在三米外说了句:“给我来一杯顶上加草莓的,少糖,冰的”,话音刚落它就出单了,甚至精准选了我眼神扫过三次的那款新品,不是那种识别半天还要你手动点的智障机器。那是我第一次实打实摸到,原来吹了快两年的多模态大模型,已经跑到这种小地方了。
以前的AI,全是偏科严重的差生
早些年我们接触的AI,大多偏科到离谱。做语音的听不懂你说的模糊描述,认图片的不会跟你唠嗑。你拿一张写满公式的草稿纸拍照,想让AI帮你算一下结果,得拆三步:先用OCR把图转文字,再把文字塞给大模型,最后等结果,中间哪一步错了全白搭。
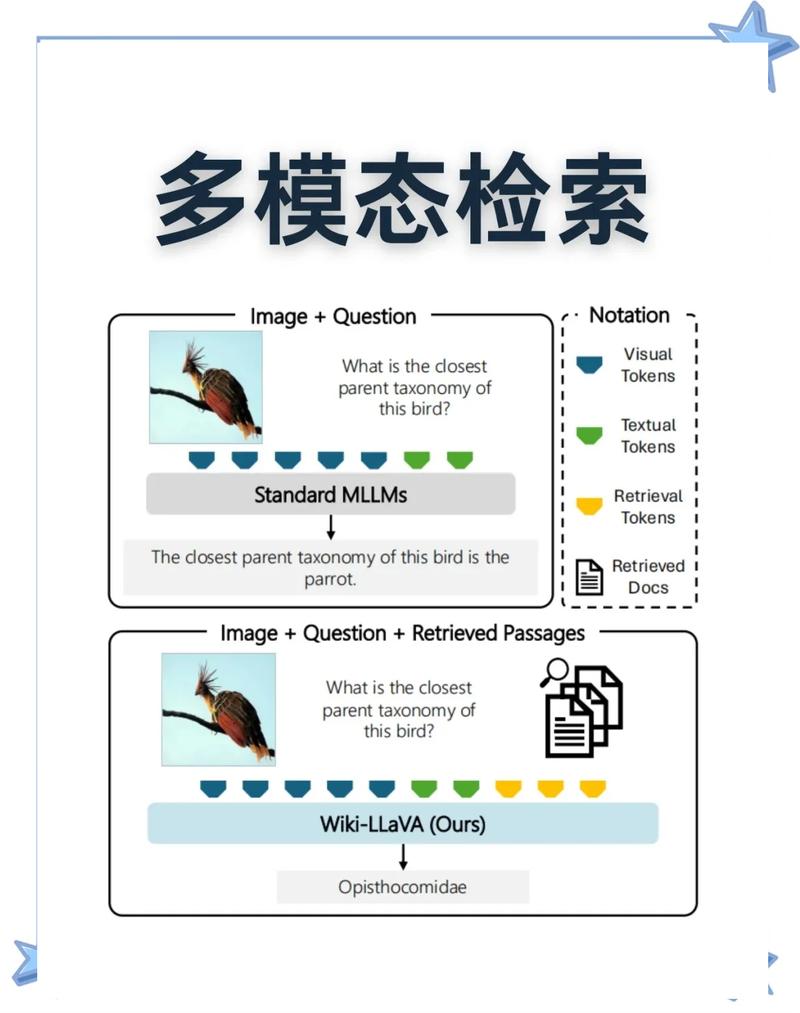
我之前帮学妹改毕业论文,就踩过这个坑。截了一张文献里的数据分析图,问当时常用的纯文字大模型,图里的趋势对不对。它一本正经给我扯了两千字,结果全是瞎编,它根本看不见我发的图是什么。
现在想想,那时候的AI,就像是蒙着眼睛跟你聊天的人,只能靠耳朵听,手里摸半天也摸不清你递给他的东西是什么。它能背万卷书,却认不出你手机里拍的猫是什么表情。
别被忽悠,不是啥AI凑一块都叫多模态大模型
现在很多厂商吹自家产品是多模态大模型,拆开看就是把语音识别、图像识别、文字大模型拼在一块,套个壳就出来卖了。这种货我试过不下五个,十个里有八个不好用。
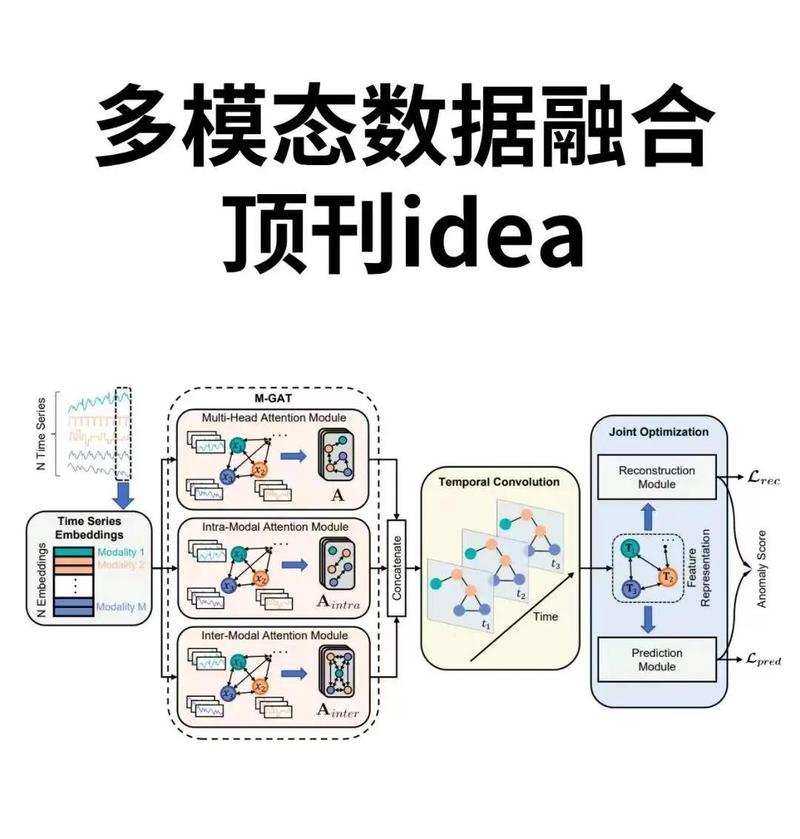
真多模态的核心,是把不同类型的信息放在同一个空间里理解,不是拼完各干各的。
就说那天点单的场景,我只说“顶上加草莓的”,菜单上其实有三款都带草莓切顶。真多模态能读懂我语音里的指代,读懂我眼神停留的位置,把这两个信息揉到一块,精准找出我要的那杯。换做那种拼出来的伪多模态,语音识别出“草莓”,图像识别出三款都带草莓,它根本不知道我要哪杯,最后还是得让你手动再选一遍,纯属脱裤子放屁。
不过话说回来,真多模态也不是完美的。那天我闲得慌,拍了做好的奶茶放在屏幕上,问它“你说这杯喝了会不会胖”,它居然跟我说,这款奶茶奶油含量很高,建议我半糖。我这杯明明是无奶油的水果茶啊!它把杯顶的草莓碎当成奶油了,你看,还是会犯傻。
它能理解模糊的需求,能对应上不同类型的信息,但碰到细节还是容易跑偏,这就是目前的现状。没那么神,也没那么废。
它已经悄悄钻进日常了,你没发现而已
很多人觉得多模态大模型是实验室里的黑科技,离我们普通人远着呢。不对,你出门用的导航,现在不少已经用上了。走到陌生的商圈路口,它能调用你手机摄像头,看懂路牌上的字,看懂你前面的围栏挡路,直接给你重新规划路线,不用你拿着手机手动搜哪里能走。
做自媒体的朋友,现在剪视频,说一声“给我把这段里出现矿泉水瓶的镜头都剪掉,开头加个淡入转场”,它能直接识别画面,给你剪好,原来得你自己拖进度条找半天,现在半小时活十分钟干完。
网上说多模态要抢好多人的饭碗,我倒觉得没那么夸张。它现在能帮你干脏活累活,比如找素材,转文字,拼初稿,但是真要做决定,还是得人来。就像我那个开奶茶店的室友,她用多模态帮她设计了十几版开业海报,最后选哪个字体,定哪个满减优惠,还是她自己拿主意。它是省力的工具,不是抢活的对手,至少现在不是。
说实话,我之前对所有吹得神乎其神的AI概念都免疫,什么颠覆啊革命啊听太多了,免疫了。但是那天站在奶茶店吧台,看着那个方头方脑的点单机一秒出单,拿到冰奶茶吸第一口的时候,我还是有点感慨。
原来AI变“聪明”的第一步,从来不是会算多么复杂的题,是终于能像我们人一样,同时用眼睛看,用耳朵听,把接收到的信息揉成一块,懂你没说出来的那点意思。它还很笨,还会做错很多事,会把草莓碎当成奶油,会画出六个爪子的猫,会瞎编工程图纸的参数,但是这种变化,已经够让人惊讶了。
剩下的,慢慢来吧。
作者|科技
排版|科技
审核|见微