2026-10-02 02:10:12
作者:
科技
上周六,09月23号,我在南京新街口旁的一家社区咖啡馆待了一下午。
邻座戴黑框眼镜的男生,对着电脑屏幕挠头挠了半小时。
他是附近大学的大二学生,跟着导师做课题,要整一篇文献综述,自己攒了三天开头都不满意,抱着试试的心态找大语言模型帮忙。
我当时在旁边偷听,差点笑出声,太真实了,谁第一次接触大语言模型不是这个反应啊——惊讶于它能说人话,又困惑它为啥动不动就胡说八道,到最后也没搞明白,这玩意儿到底是怎么干活的。
你拿到的不是答案,是文字的概率拼图
说实话,我第一次搞懂大语言模型的核心逻辑时,惊得把手里的冰咖啡都放下了。
很多人以为大语言模型是个装了全世界知识的超级数据库,它把问题搜一遍,然后把答案整理出来给你。
不是这么回事。
它从来不是“记住”了知识,只是摸透了文字和文字之间的连接规律。说穿了,它的工作从头到尾只有一件事:猜下一个字是什么。
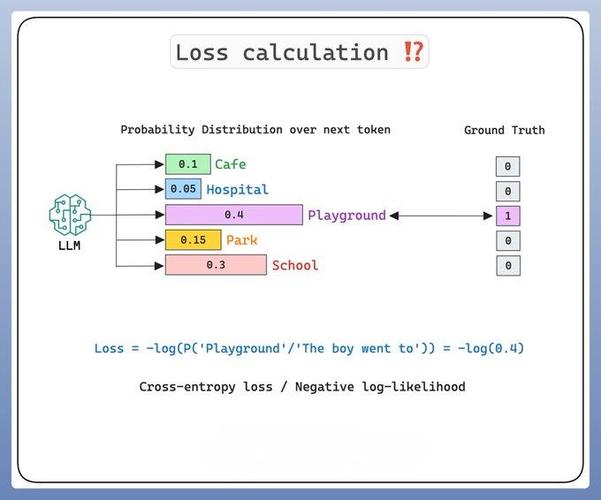 大语言模型下一个字概率预测示意图
你输入“今天去南京中山陵,天气真”,它会把过去几十年里互联网上所有出现过这段文字前缀的内容统计一遍,算出来每个可能接在后面的字的概率:“好”占了78%,“棒”占14%,“热”占6%,剩下零零碎碎加起来不到2%。它挑概率最高的那个放出来,然后接着猜下下个,再下下个,一段通顺的话就这么拼出来了。
所有训练,其实都是在调这个概率的准度。它吃进去上千亿的文字内容,一点点修正自己对文字连接的判断,越练越知道,什么样的话读起来像正常人说的。
哦对,你奇怪它为什么会一本正经胡说八道?其实太好理解了。它的目标本来就是拼出一段逻辑通顺的话,不是拼出正确的话。只要文字符合语法符合语境,概率对了,哪怕事实错得离谱,它也会脸不红心不跳地说出来。
骂它骗人其实有点冤枉,人家从一开始就没说自己是来给你当百科全书的啊。
那些你踩过的坑,全是对它的误解
接触大语言模型的人越多,奇奇怪怪的误解就越多。
我听过最离谱的一个,说未来全都会被参数百万亿的超级大模型统治,小模型根本没有活路。
越大的模型就一定越好吗?
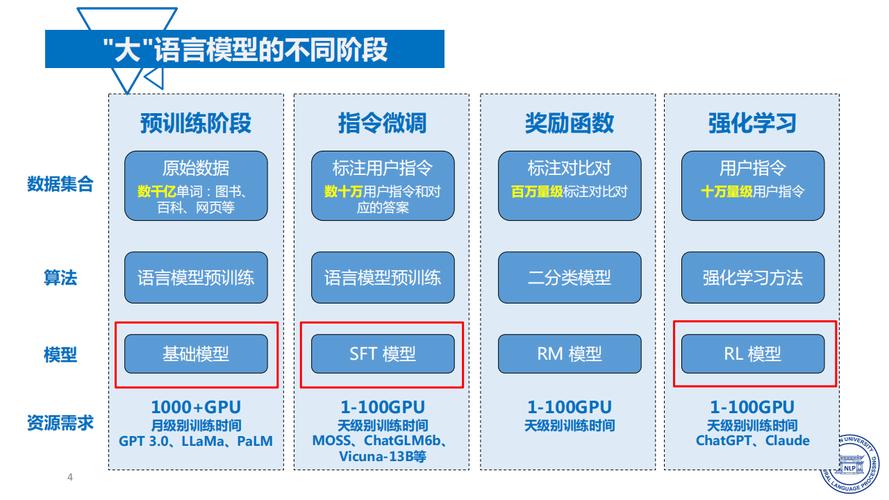 不同参数规模大语言模型效果对比图
我上个月接触过一个做本地生活的团队,他们给商家做自动写好评文案的工具,用一个不到百亿参数的小模型,效果比那种千亿参数的大模型还好。为什么?因为人家只需要学电商文案的语气,不需要知道量子力学怎么回事,大模型学了一堆杂七杂八的内容,反而容易跑偏,小模型针对性训练,又快又便宜,准确率还高。
第二个常见误区,就是说大语言模型会抢走所有笔杆子的工作。
我认识一个做原创情感号的作者,原来一周更两篇都累得要死,现在用大模型帮她找素材整理读者故事,搭初稿框架,自己只需要改语气加自己的真实感悟,现在一周更四篇,粉丝涨了快一倍,收入翻了快两番。
取代谁了?取代的是那些只会抄模板凑字数洗稿的人,不是真的有自己想法有自己风格的人。
还有个最玄乎的说法,说大语言模型已经产生意识了,再过几年就能取代人类。
别瞎想了。它拼出来一段安慰你的话,那是因为互联网上成千上万的人安慰别人都是这么说的,概率摆在这里,它就这么拼了,不是它真的感受到了你失恋的心痛。
不过话说回来,深夜你emo的时候,它愿意秒回你一段软乎乎的安慰,比你那个只会说“多喝热水”还半天不回的对象强,这点我承认。
它最终会变成你身边看不见的工具
 它最终会变成你身边看不见的工具
现在圈里都在拼参数拼规模,好像谁参数大谁就是赢家。我倒觉得,未来大语言模型的方向,刚好反过来,是往小了做,往你身边塞。
你现在用的输入法,已经会猜你下一个字打什么了对吧?以后的输入法,不用你说太多,打两个关键词,就知道你要给老板发请假消息,还是给闺蜜发约饭的消息,能直接给你整出符合你语气的整句话,不用你一个个敲。
你家里的旧笔记本,不用换,装个小参数的大语言模型,本地就能跑,不用传数据到云端,隐私还安全,就能帮你整理整理桌面的文件,给你写点日常的备忘录,比现在的智能助手好用一百倍。
很多人天天喊AI威胁论,说大语言模型会毁了这个毁了那个。其实它本质就是个帮人写字的工具,和当年的打字机,后来的word,没什么本质区别。
打字机没有取代作家,word也没有取代作家,大语言模型也不会。它只是把原来你要花两三天找资料搭架子的活,几秒钟给你干完了,省下来的时间,你去想那些只有人才能想出来的东西,去见朋友,去逛中山陵看枫叶,去喝冰咖啡,不好吗?
昨天我还用它帮我整理了去年秋天去南京栖霞山看枫叶的一堆照片的配文,省了我一下午的时间,我转头就去楼下买了个芋泥奶冻卷,边吃边刷剧,爽得要命。
你看,它本来就该是这样的东西。帮你省力气,给你腾出来时间过生活,不是吗。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:咖啡馆里的聊天机器人,藏着大语言模型的全部秘密
文章链接:https://www.lfdjt.com/p/keji/a/5489.html