 大讲堂
去年秋天,我在南京先锋书店门口拍过一只橘猫。照片很糊,猫脸都虚成一团。后来我在手机相册里搜“橘猫 书店 玻璃反光”,它居然真被翻出来了。那一刻我有点恍惚——多模态大模型是不是已经“看懂”了?
嗯,没那么玄。它做的事,更像把照片和文字扔进同一张地图,然后找离得近的点。
它不是在“看”,更像在把世界翻译成坐标
你给模型一张图,它先把图切成小块,每个小块变成一串数字。文字也一样,被拆成词元,再变成另一串数字。两串数字被压进同一个高维空间。猫的耳朵、橘色、玻璃反光、书店招牌,这些概念在空间里各占一个位置。
所谓“理解”,很多时候是向量之间的距离够不够近。
2021年公开的CLIP论文里,研究者用大量图文对训练模型:配对的图和文拉近,不配对的推远。这招很朴素,效果却凶猛。后来很多多模态大模型都沿着这条路走,只是骨架越搭越大。
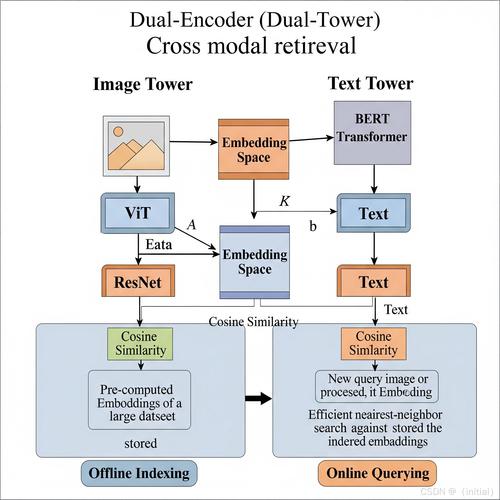
但注意,坐标近不等于真懂。你搜“橘猫”,它可能把“橘色沙发”也翻出来。为什么?因为在它的地图里,橘色、毛茸茸、室内,这几个坐标挨得太紧。它没经历过“猫会跳上沙发”这件事,只见过“猫”和“沙发”经常一起出现在文字里。
这就像你让一个只读过菜谱的人去炒菜。他能背出“少许盐”,手一抖,还是咸死。
眼睛、耳朵和嘴:模型内部谁在干活

外面看,多模态大模型是一个对话框。里面拆开,通常有几块拼图。
一块是视觉编码器,负责把图变成视觉词元。常见的有ViT,也可能用卷积网络。它像个翻译官,把像素翻译成语言模型能吃的 token。另一块是语言模型,负责接话、推理、写答案。中间往往有个投影层或者连接器,把视觉 token 调整到语言模型的维度。
所以它不是一只完整的“电子脑”。更像一个临时剧组:摄影师、翻译、编剧、演员,各管一段。
视觉编码器决定它能看到多少细节,语言模型决定它能说多圆。连接器要是没对齐,就会出现“图里明明是狗,它硬说猫”的尴尬。
开源社区里,LLaVA这类工作把视觉编码器和语言模型拼在一起,再用指令数据微调。思路不复杂,难的是数据配比、训练稳定性和幻觉控制。说实话,调这玩意儿像养猫。你以为它学会了,它转头把水杯推下桌。
幻觉、盲区和那些被吹过头的“理解”

先泼点冷水。
多模态大模型能描述图片,不代表它理解因果。你问“这个人为什么皱眉”,它可能说“因为光线太强”。它没看见前因后果,只是在猜下一个词。
它也可能读不懂空间关系。左边、右边、上面、下面,在二维图里还好,一到三维遮挡就露馅。视频更麻烦。很多模型处理视频的方式是抽几帧,当成幻灯片看。帧与帧之间的动作,它经常接不上。
还有OCR。文字识别强,不等于推理强。菜单上的价格它认识,但问“两个人点哪几样不超预算”,它可能开始编。
这不是骂它。这是提醒你:多模态大模型的能力边界,往往藏在“看起来会”和“真的会”之间。
有人问,那它能干什么?
能干的不少。比如给视障用户描述街景,帮老师批改带图作业,在工业质检里找划痕,在医疗影像里做初步筛查。前提是有人兜底,有流程管着。让它独自签字?算了。
时间线:从看图说话到边看边操作
早些年,图像描述模型只会说“一只猫坐在沙发上”。句子像模板,换个图就不灵。
后来有了视觉问答,模型开始回答“猫是什么颜色”。再往后,CLIP把图文对齐做成了通用底座。2022年前后,Flamingo这类工作尝试把视觉和语言模型交错训练。2023年,GPT-4V、Gemini等把多模态对话推到大众面前。同一年,开源社区冒出LLaVA、Qwen-VL等路线,大家开始拿消费级显卡折腾。
到2024、2025年,方向又变了。模型不只想“说”,还想“做”。看屏幕、点按钮、操作软件,这叫图形界面代理。还有具身智能,让模型指挥机械臂。听上去很酷,做起来很苦。因为真实世界不给标准答案,也不给你重试机会。
冷思考:我们到底需要它“看懂”什么
我越来越觉得,多模态大模型的真正问题不是“能不能看懂”,而是“看懂之后要干嘛”。
如果只是搜照片、读发票、描述风景,那它已经够用。如果要用在手术台、方向盘、高压电线上,那就得换一套评价方式。不是看它答得多流畅,而是看它什么时候闭嘴、什么时候求助。
一个会承认“我看不清”的模型,比一个硬编答案的模型有用得多。
隐私也是绕不开的。你把家庭照片传上去,模型看见的不只是猫,还有门牌号、快递单、孩子的脸。企业用多模态做质检,产线画面可能涉及工艺机密。这些数据怎么存、怎么删、谁能看,都是工程之外的事。
能耗同样实在。视觉 token 比文本 token 重得多。一张高清图拆成几百上千个 token,推理成本蹭蹭涨。端侧多模态是趋势,可手机发热和续航不会说谎。
所以,别急着把多模态大模型当成“有眼睛的大脑”。它更像一套刚学会看图说话的神经系统。有时惊艳,有时离谱。你得知道它哪里靠谱,哪里在胡扯。
回到那只橘猫。它被搜出来,不是因为模型认出了“去年秋天”“先锋书店”“玻璃反光”这些故事。它只是把一堆坐标对上了。可这已经足够让我愣一下。
技术的有趣,常常就在这种半懂不懂的缝隙里。对吧?
作者|科技
排版|科技
审核|知知