 大讲堂
0923,南京。凌晨三点,雨点砸在机房外墙上。里面风扇声像一群不睡觉的蝉。你手机里的AI助手回你一句话,可能就有一排加速卡在同时喘气。算力这词被说烂了。可它到底指什么?
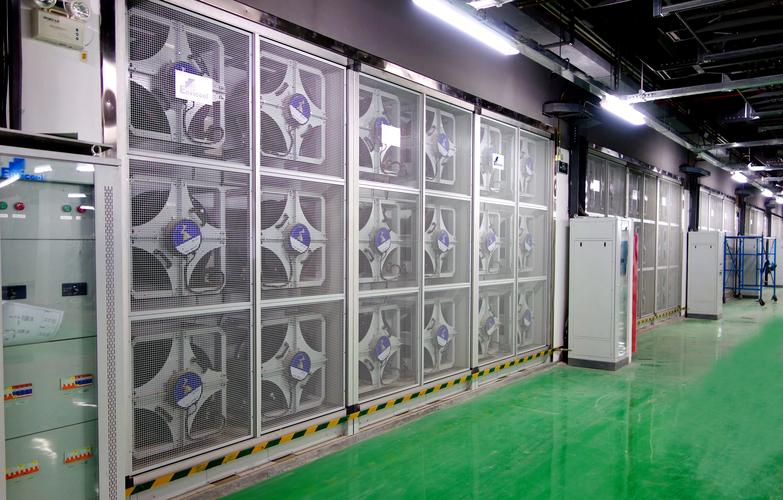
先别翻定义。看一个动作:数据从内存搬到缓存,进计算单元,再搬回去。就这么来回倒腾。倒腾得够快,算力才真的有用。
算力不是“算得快”,更像一条被堵住的路
很多人把算力理解成芯片跑分。跑分高就强。嗯,有道理,但不全对。算力更像物流系统。发动机再猛,路上堵死,货也到不了。计算单元是发动机,内存带宽是路,缓存是临时仓库,调度是交通指挥。AI训练里全是矩阵乘法。乘加本身不慢。慢的是喂数据。你把一大堆数字搬进搬出,搬运速度跟不上,计算单元就干等。
GPU为什么适合干这个?它有很多小核,能同时做大量简单运算。CPU像几个博士,GPU像几千个小学生做口算。这个比喻不严谨,但画面感够了。问题也来了:显存不够、带宽不够,算力就会被卡住。业内常说的内存墙,讲的就是这个。

训练和推理,是两种不同的吃算力方式
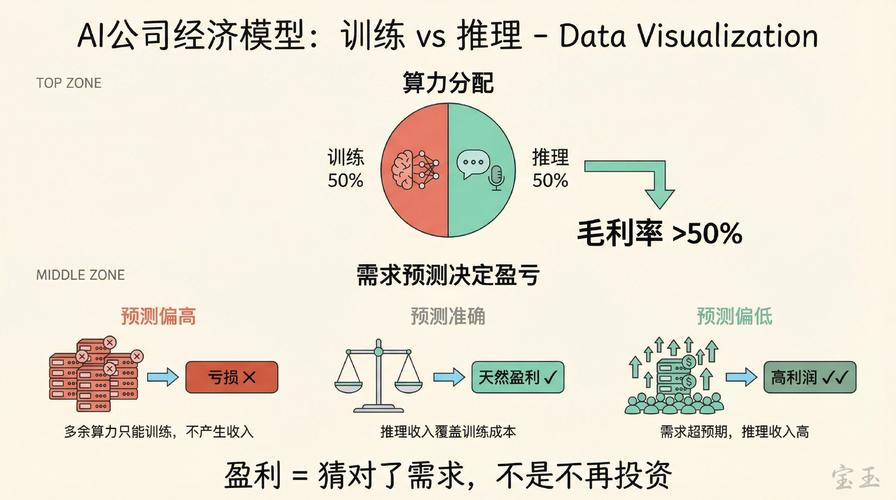
训练像教小孩认猫。看几百万张图,猜错就调权重。前向、反向、更新,一轮又一轮。吃算力,吃时间,也吃电。推理呢?模型已经训好。你问它答,它做前向计算。听起来轻,但架不住量大。一个人问一次没事。一千万人同时问,机房就开始冒汗。
推理还特别挑场景。语音助手,你不想等三秒。自动驾驶,更不能等。所以有些计算要放到边缘。摄像头旁边挂个算力盒子,先把人脸、车牌、异常行为筛一遍,只把有用的传回机房。延迟低,带宽省。代价是模型小,精度可能打折。没有免费午餐。云端推理可以上大模型,但网络来回一趟,延迟就上去了。
买卡不是终点,电和散热才是暗线
机房怕什么?热。电。一张加速卡功耗几百瓦,一排机柜像电暖器。风冷不够,液冷上场。冷板式液冷、浸没式液冷,名字听着硬核,本质就是别让芯片烧了。还有配电。UPS、变压器、柴油发电机。这些不酷,但决定算力能不能持续跑。你买得到卡,不一定供得上电。南京夏天闷,机房空调压力不小。运维师傅半夜盯着温度曲线,比看股票还紧张。
还有个容易忽略的:网络。训练大模型不是一张卡干活。几百张卡要同步梯度。网络慢了,大家互相等。所以高速互联和拓扑设计,跟芯片本身一样要命。你堆了一屋子卡,结果通信堵成早高峰,利用率就难看了。
那我现在要不要囤算力?

有人问,云上租和自建,怎么选?看任务。短期实验、需求波动大,租。长期稳定、数据敏感、团队有运维能力,自建或混合。别为了面子买卡。卡会折旧,电费不会客气。
又问,消费级显卡能跑大模型吗?能。慢一点,小一点,量化一下也能玩。但别拿它去训百亿参数模型。显存会先哭。再问,算力会一直涨吗?需求在涨,效率也在涨。量化、蒸馏、稀疏化、更好的注意力机制,都在省算力。算法优化有时比换硬件还猛。
普通人怎么理解算力?把它想成水电加带宽加调度。不是单一资源。同样一批卡,任务排得好,利用率高。排不好,空转。调度器像食堂阿姨,手一抖,队伍就乱了。
从CPU到GPU,再到算力网
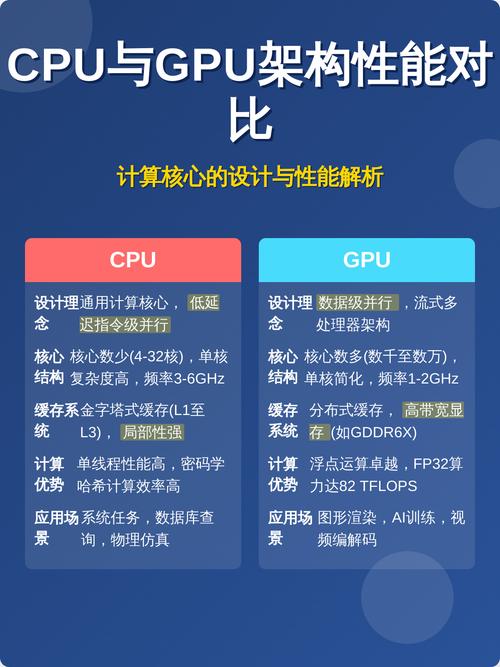
早些年,科学计算靠CPU集群。后来GPU通用计算起来了,CUDA把并行计算的门槛拉低。再后来,专用芯片冒出来,TPU、NPU,各干各的活。现在又提算力网络。把多地数据中心连起来,按需调度。听着像电网。但数据不是电,搬来搬去要花时间、花带宽。所以不是什么任务都能随便调。
东数西算这类工程,做的就是算力布局。离线训练、冷数据加工,可以放到能源更便宜的地方。实时推理、交互应用,还是得靠近用户。不然你点一下,数据跑半个中国,体验就碎了。算力网不是一张无限快的网。它更像一张有重力的网。越靠近用户,越贵,也越及时。
冷思考:算力不是魔法,瓶颈会转移
算力涨了,模型胃口也涨。参数量、上下文长度、多模态输入,全在吃。今天觉得够用的卡,明年可能就紧。但另一面,小模型和端侧模型也在进步。不是所有事都要大模型。关键词提取、简单分类、固定格式转换,小模型足够。别被越大越好洗脑。
成本也别忘了。训练一次大模型,卡时、电费、人力,都是钱。推理每次调用也有成本。产品设计要算单位经济。如果每次回答都烧钱,商业模式就悬。还有隐私、合规、数据质量。算力是燃料,数据是食材,算法是菜谱。厨子不行,火再大也白搭。
回到凌晨的机房。风扇还在转。指示灯一闪一闪。算力不是抽象名词,是电、硅、水、代码、人。你看到的每一个流畅回答,背后都有一群机器在搬数字。下次听到算力,别只想到显卡。想想那条从内存到芯片的路,想想电费和散热,想想调度。也想想,我们到底要用它来算什么。
作者|科技
排版|科技
审核|见微