2026-10-25 05:49:20
作者:
科技
上周三加班到九点半,出公司门撞见常喂的三花蹲在台阶上,尾巴卷成个问号,爪边沾了半片被雨打湿的桂花。我掏手机拍了张照,顺嘴就把图丢进了平时用的那个多模态对话框里。
没输文字。
本来只想让它帮我配个发朋友圈的文案,结果它先蹦出来一句:”这只猫左前爪有点颠,是不是前阵子被电动车蹭过?它现在蹲的位置刚好是风挡不住的拐角,你平时喂它的粮,是不是都放在那棵悬铃木的树根边?”
我当时站在冷风里愣了三秒。
不是”能看图说话”,那都是老黄历了
很多人对多模态大模型的印象,还停留在好几年前的图像识别工具——给张图,列几个元素标签,说”图里有猫、有树、有路灯”,干巴巴的像查户口。
真不是。
以前的老模式说白了就是”翻译转译”:先用单独的图像模型把图片内容拆成文字描述,再把这些文字喂给语言模型生成回答。相当于你找了个完全没见过图片的人,对着别人给的元素清单编故事,传着传着,那些藏在细节里的温度就全丢了。
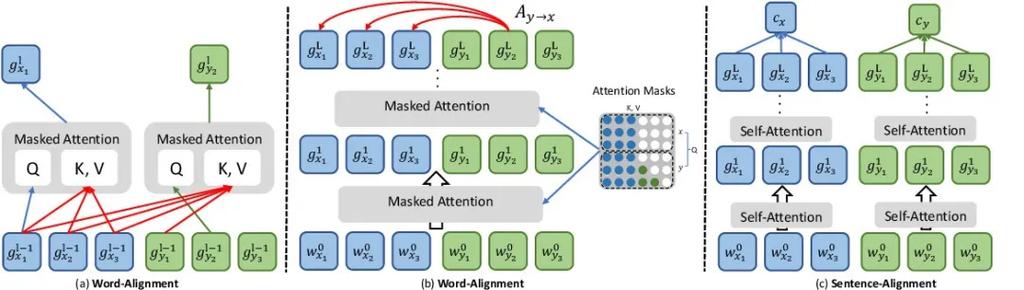 多模态大模型跨模态信息对齐示意图
现在的多模态,是把图片的像素块、文字的语义、甚至声音的波形,全拆成可以互相匹配的”语义密码”。就像所有参与对话的人坐在同一张桌子上,不用中间的翻译官传话,看到的、听到的、读到的,全是同一套逻辑里的信息。
我朋友之前在家烤戚风,把烤箱温度曲线的截图丢进去,它能认出图里的折线,甚至能指出哪一段温度掉太快会导致面糊塌腰,还能结合他之前提过的”家里烤箱温差有20度”的记忆,直接给了调整上下管温度的具体建议。换做以前的图文识别工具,最多给你标个”这是一张折线图”,剩下的全靠你自己琢磨。
那些被吹得神乎其神的功能,其实离日常很近
每次看到网上把多模态大模型吹成”能改变世界的终极武器”,我都有点想笑。它真的没那么远,日常能用的场景,全是碎得不能再碎的小事。
早上起来你对着它拍一下桌上剩的半盒早餐奶,它能告诉你还有三天过期,顺嘴提一句你上次收藏的同品牌燕麦片在哪个购物软件里;你拍一下孩子在作业本上画的歪歪扭扭的奥特曼,它能顺着孩子的画讲一整段配套的冒险故事,不会像以前的故事机那样翻来覆去就是那几个桥段。
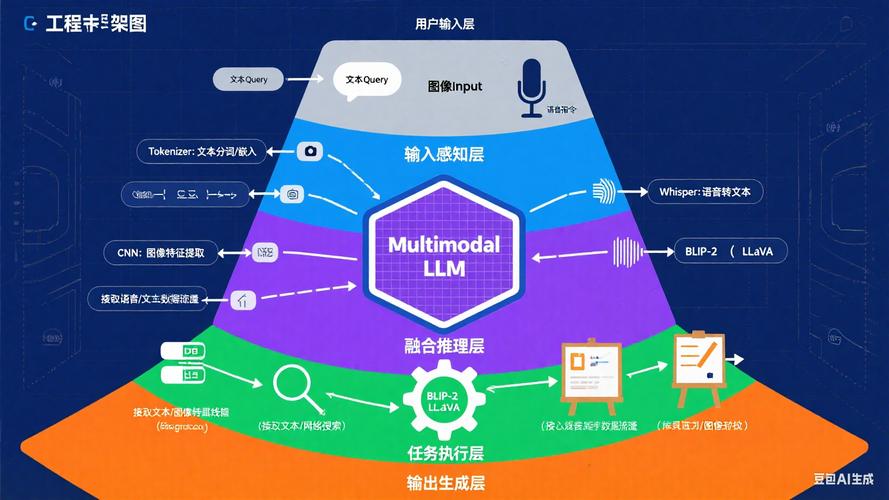 普通用户日常使用多模态大模型的真实场景图
我妈上周还专门找我,问能不能用这个功能帮她数广场舞的动作节拍。她之前排新舞,找排舞老师数节拍要花两百块,我对着她拍的一段15秒的跳舞视频丢进对话框,半分钟就出了每段动作对应的鼓点时间,比老师数的还准。
它最核心的能力,从来不是”能处理多少种格式的文件”,而是能跳过”把感受转成文字”这步最费劲的流程。对吧,我们平时用工具最累的是什么?是你脑子里已经有个模糊的画面了,要费劲把它拧成干巴巴的文字指令,说清楚你要什么。现在不用了,你把图、把视频、把录音直接丢进去,它能接住你那些没说出口的观察。
别神话它,它的”记性”其实还挺挑
说回上次那只三花。我后来把去年冬天在同一个位置拍的三花照片丢进去,它居然没认出是同一只猫。
给我气的。
问了做算法的朋友才知道,现在的多模态对跨时间的长期记忆,其实还没那么稳。尤其是你每次丢的图片没有明确的特征标记时,它能捕捉到的都是当下这张图里的显性细节,不会像人一样,看到猫耳尖的那个小缺口,就立刻想起”哦这是上次喂了半根火腿肠的那只”。
更别说那些容易闹笑话的场景了。我上次把猫打哈欠的照片丢进去,它说我图里是一只正在伸懒腰的狐狸;我拍了自己手写的待办清单,字写得稍微有点歪,它把”下午三点开会”认成了”下午三点开吃”,搞得我那天下午真的差点忘了开会。
别信那些商家吹的”全场景通吃”的宣传。它现在就是个刚学会接各种素材的助手,遇到需要专业资质的场景——比如解读医疗报告、分析工程图纸,它给的内容最多当个参考,千万别直接照着用。
那天我给三花喂了半袋猫条,它吃完甩甩尾巴钻到树丛里去了。我站在台阶上想,等下次它再蹲在这里,我再拍张照丢给那个对话框,说不定它还能认出,这只猫上次见我的时候,爪边沾了半片桂花。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:把刚拍的楼下流浪猫照片丢给多模态大模型,它居然说出了我没说出口的观察
文章链接:https://www.lfdjt.com/p/keji/a/13335.html