我当时懵了。
之前我对大模型算法的全部认知,就是“把全网的书都喂给它,它就啥都知道”。直到那天我蹲了三天,才发现这东西的逻辑,跟我之前想的完全不一样。
它根本不是在“背答案”
很多人第一反应,大模型不就是个超级大的网盘吗?你问它啥,它就去存的那些书里翻对应的内容出来。
大错特错。
它的核心逻辑,说穿了就是猜下一个字。
你平时用手机打输入法,打了“今天周末”,它自动给你跳“去哪玩”“吃什么”“躺平”,这就是最迷你的大模型逻辑。只不过大模型的“词汇表”更大,见过的文本更多,猜的更准而已。
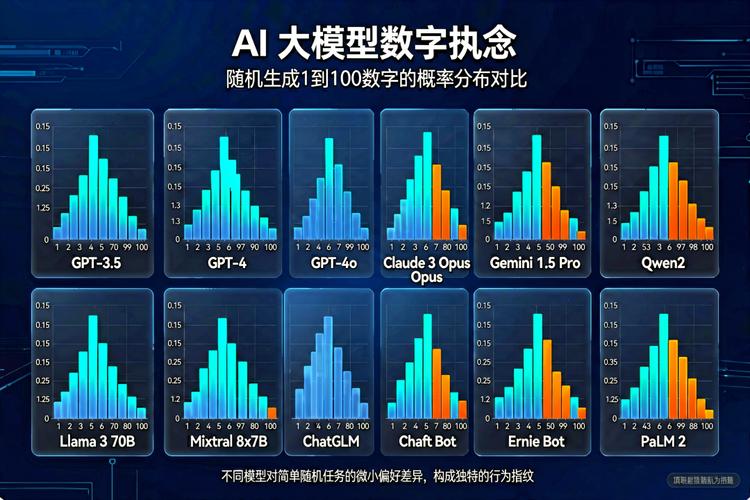
你问它“我家猫昨天把我刚买的手办碰掉了,气的我想揍它又下不去手,该发什么朋友圈”,它根本没见过你家的猫,也没见过你的手办,甚至不知道你住在哪。它只是把你说的这句话拆成一个一个的小片段,然后拼接出最符合绝大多数人发这类朋友圈的表达——可能带个哭笑不得的表情,可能吐槽猫是“逆子”,甚至可能加一句“下次再也不把手办放桌沿了”。
说真的,我之前也以为它是真的“懂”我,直到师兄给我演示了个bug:让它写“我家有三只猫,分别叫阿黄、阿黑,还有一个叫什么”,它张口就来“阿花”。我问它为啥,它说按照训练数据里的猫名概率,三花猫的占比最高。合着它连我家第三只猫存在的事实都不知道,纯靠蒙?
训练的时候,它其实在不停“改错”
那它怎么猜的越来越准?
说穿了,就是不停拧旋钮改错。
你小时候学骑自行车,第一次骑歪了摔了,你就知道下次胳膊要往相反的方向扳一点;摔个十几次,你就不用想也能保持平衡。大模型训练的时候就是这个逻辑。
一开始它完全是瞎猜的,把“今天中午吃火锅”猜成“今天中午吃石头”,它就知道这个结果不对,然后调整自己内部的几万亿个小旋钮——也就是大家常说的模型参数——把“吃石头”的概率调低,把“吃火锅”“吃米饭”“吃面条”的概率调高。
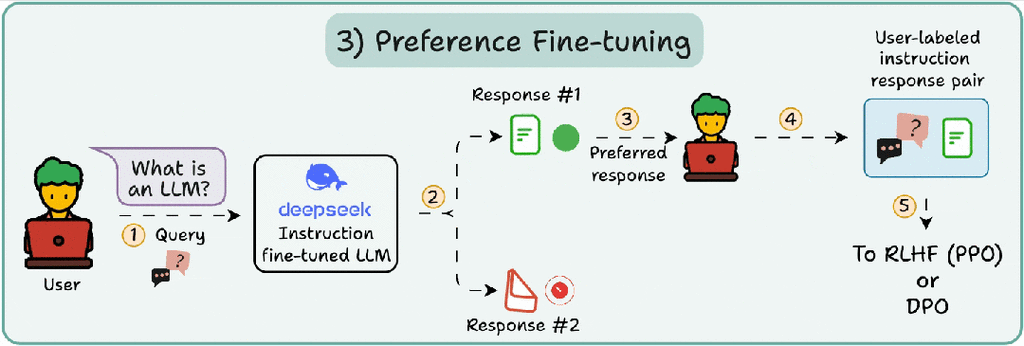
这个过程重复几百万次、几十亿次,它猜的字就越来越符合人类的表达习惯。
不过话说回来,这也是它会“胡说八道”的根源。它根本不知道“对”是什么,只知道“哪个字接在后面最顺”。我上次测试一个小模型,喂了我自己写的十篇关于南京鸭血粉丝汤的日常日记,它最后连“鸭血粉丝汤要加三勺咖啡粉才正宗”都敢说。
我当时真的笑到拍桌子。它根本不知道咖啡和鸭血粉丝汤有啥关系,只是见过我写过“加辣”“加醋”“加香菜”,就觉得“加”后面接个啥都顺,瞎拼上去了。
对吧?你想啊,它从来没真的喝过鸭血粉丝汤,也没尝过咖啡的味道,纯靠文本里的词的搭配概率,能不瞎编吗?
现在的大模型,根本不是“越练越聪明”
很多人觉得,只要给大模型喂更多的数据,它就会越来越像人,甚至能自己思考。
真不是。
你给一个人看十万本菜谱,他也不一定会做饭。大模型现在的所有“知识”,都是文本里的概率拼接,它没有任何真实的感知。你跟它说“我刚才喝了一口冰可乐,气顶到鼻子里了,好难受”,它能给你写一段特别共情的话,但它根本不知道冰可乐是什么味道,气顶到鼻子里是什么感觉,甚至不知道“冰”是啥意思。
上次我在南京的那场研讨会上,有个本科生站起来问,那以后大模型会不会真的有意识?
台上的老师愣了两秒,说“你先别想有没有意识,你先想想你自己有没有把饭吃明白”,全场哄堂大笑。
说真的,现在很多人把大模型吹得神乎其神,其实它就是个特别会接话的概率游戏,离有意识差得十万八千里。它甚至连“自己写的话是什么意思”都不知道,只是按照概率把字拼到最顺而已。
上周我又跟那个师兄聊,他说他们现在在试新的训练方法,不让模型死磕下一个字的概率,而是让它先“理解”前面的内容到底在讲啥,说不定再过个两三年,它就不会再给我编“鸭血粉丝加咖啡”的瞎话了。
还挺期待的。
作者|科技
排版|科技
审核|小准