 大讲堂

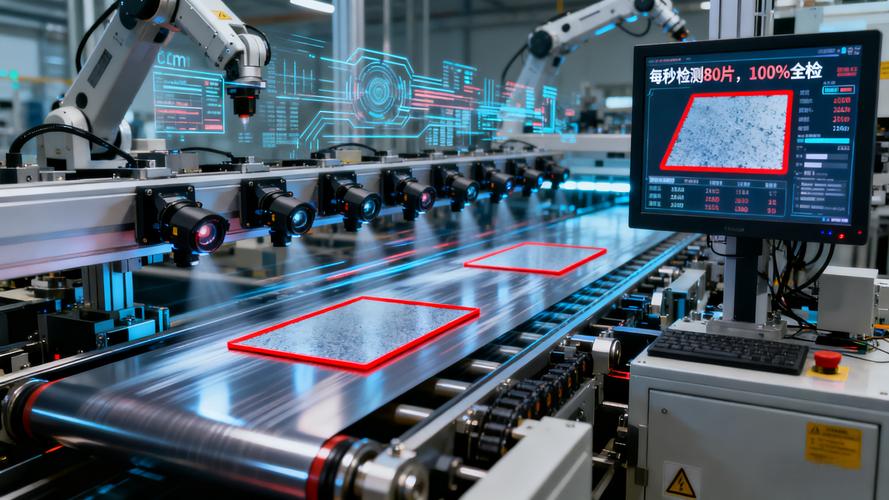
上周和一个做制造业的朋友吃饭,他说公司花了200万上了套机器学习质检系统,结果跑了3个月,漏检率比老工人的目视检查还高8个百分点。我当时嘴里的冰粉都差点喷出来。
这不是个例。最近两年我跑了快40家做数字化转型的传统企业,一半以上都踩过类似的坑:被供应商吹得天花乱坠,掏了大价钱上系统,最后发现要么不好用,要么用不起来,钱打了水漂。大家对机器学习的认知,现在基本处在两个极端:要么觉得这是能颠覆所有行业的魔法,要么觉得这就是骗钱的噱头。
被混淆的技术边界:到底什么才算真的机器学习
先把最基础的概念掰扯清楚。很多供应商嘴里的“机器学习系统”,本质上就是把过去的人工判断规则写成了代码——比如“如果检测到图片上有3个像素以上的黑点,就判定为不合格”,这根本不是机器学习,就是个规则引擎。
真正的机器学习,不需要人工逐行写死判断规则,而是从标注好的样本数据里自动总结规律,再对新输入做判断。举个最直白的例子:你给模型喂1000张带“猫”标签的照片,再喂1000张不带猫的照片,它会自己总结出猫的轮廓、纹理特征,下次看到新的照片,就能判断里面有没有猫。

但很少有人会告诉你这个技术天生的瓶颈:它的准确率上限,根本不是算法有多先进,而是你喂给它的样本数据质量有多高。开头提到的那家制造企业,当时为了赶项目上线,只攒了不到100张不合格零件的瑕疵照片,剩下的几万张全是合格产品的样本。模型学了俩月,根本不知道不合格的零件长啥样,漏检率高不是必然的吗?
更有意思的是,很多人觉得只要把大模型、复杂的神经网络堆上去,准确率就能上去。实际上现在工业界用得最多的机器学习模型,还是十几年前就发明的逻辑回归、随机森林——算法本身早就成熟了,真正拉开差距的,从来都是你手里的标注数据够不够多、够不够准。
现在的产业落地,卡在了哪一步
说句实在话,现在真正跑通商业闭环的机器学习落地场景,90%都集中在两个赛道:互联网平台的内容推荐,和金融机构的风控反欺诈。剩下的所有赛道,基本都在踩坑的阶段。
之前接触过一个做生鲜供应链的创业公司,去年想搭一套机器学习的销量预测模型,一开始算得特别好:只要模型预测准了,库存损耗能降20%,一年能省几百万。结果模型上线才俩月,先是遇到疫情封控,接着赶上连续一周的极端高温,然后平台突然给了一波免费流量补贴,所有的历史数据全失效了,模型预测的销量和实际差了3倍,最后压了3000万的货在冷库里。
这里有个所有企业做项目时都会忽略的隐形成本:很多人算机器学习项目的ROI,只算了买服务器、付算法开发费的钱,没算数据清洗、人工标注、持续迭代的成本。这部分钱,往往是初始项目投入的3-5倍。更要命的是,现在整个行业的最大误区,是把“模型训练完成”当成了项目结束的节点。实际上模型上线之后,因为业务场景变了、用户行为变了、生产工艺改了,数据会持续发生“分布漂移”,如果没人每个月花人力重新调优,三个月之后模型的准确率就会掉到根本没法用的程度。
现在国内做机器学习解决方案的厂商,基本分成三拨:第一拨是互联网大厂,拿自己内部的流量、交易数据练手,把成熟的能力打包成云服务卖;第二拨是垂直领域的小创业公司,盯着某个细分场景死磕数据,比如专门做某类零件的质检、专门做某类农货的价格预测;第三拨是最坑的皮包公司,连开源模型都改不明白,套个现成的开源界面就敢接项目,专骗传统企业的数字化转型预算。
那些没人敢明说的风险与治理漏洞
聊完落地的现实问题,再说说藏在水面下的风险。第一个最突出的就是数据合规问题。很多厂商为了提升模型的准确率,根本不管用户授权的边界,偷偷爬取用户的聊天记录、消费轨迹、位置信息,甚至把用户的病历、银行卡号这种敏感信息直接拿去训练模型。之前某家做智能客服的公司,因为把未脱敏的用户对话拿去训练大模型,最后被监管罚了几百万,这种事现在根本不少见。
第二个是算法自带的偏见问题。比如之前某家银行的机器学习风控模型,因为训练样本里某类地区的历史逾期率偏高,就直接给这个地区的所有申请用户打了低信用分,根本不管个体的实际收入、还款能力。这本质上就是把过去存在的地域偏见、群体偏见,用算法的包装固定成了“客观规则”,连申诉的空间都没有。
还有个更隐蔽的问题:黑箱。现在很多企业的核心决策,已经开始依赖机器学习模型的输出,但没人能说清楚模型到底是基于什么逻辑做出的判断。比如你申请信用卡被拒,模型说你的风险评分不达标,但你问它为什么,它说不出来——这时候你连找谁说理去?
聊了这么多坑,说点实在的预判,就看未来3-5年的发展,别信那些“机器学习会取代一半人类岗位”的鬼话。真正能跑通商业价值的落地场景,根本不是那些喊得最凶的“通用人工智能”,而是单一场景下、数据积累足够厚、规则足够明确的窄域应用。比如制造业里特定零件的表面瑕疵检测,电网里特定输电线路的故障预判,零售里固定品类的日常销量预测。那些拍着胸脯说要做“全场景通用机器学习平台”的公司,大概率活不过明年。
还有个很现实的趋势:接下来3年,机器学习项目的报价会持续往下掉。现在开源的视觉模型、语音模型已经越来越成熟,大家再也不会为了一个套壳的模型付几十万的智商税。去年我见过一个做汽车零部件质检的小工厂,没买大厂的贵价系统,就找了个计算机系的在读学生,用开源的视觉模型,自己标了3000张瑕疵样本,总共花了2万多块钱,最后搞出来的检测系统,比之前花100万买的大厂系统准确率还高。你说这事找谁说理去?
治理层面的变化也会跟上。接下来监管会慢慢把数据标注的合规要求、算法决策的可解释性要求提上来,那些靠偷数据、靠黑箱模型赚快钱的公司,会被慢慢清出市场。机器学习从来不是什么魔法,它就是个工具——和100年前的机床、30年前的ERP系统没有本质区别。你拿它用对了场景,就能帮你省钱提效;你被人忽悠着花大价钱买个神化的概念,那最后大概率要交学费。
作者|大讲堂
排版|大讲堂
审核|小北