 大讲堂

我至今记得2022年双11凌晨三点,在杭州某电商运维室蹲到的那一幕:屏幕上某个服务节点的CPU占用率红条直接捅到99%,旁边的运维小哥攥着的冰可乐都洒了半罐,没到30秒,流量被自动切走,红条慢慢回落到12%。
没人在群里发感谢。
所有人都松了半口气。
救场的不是什么神仙AI,是跑了快20年的负载均衡系统。你刷短视频时每滑一下的请求,点外卖时选完地址提交的订单,甚至你在银行APP里转一笔账的操作,在到达真正处理业务的服务器之前,都要先经过一层负载均衡系统的判断,决定把你送到哪个能最快给你反馈的节点上。
别把负载均衡当”流量分发器”,这是行业最常见的认知偏差
说实话,很多做了三四年的开发,都没真正搞懂负载均衡的边界在哪——他们总觉得这是运维的事,直到自己写的服务被不合理的流量策略打挂,才会回头去翻路由规则的文档。
负载均衡的核心矛盾从来不是”分流量”,而是在算力有限的前提下,把请求匹配给”当下最能接住这个请求”的节点。很多人对负载均衡的认知还停留在”轮询”阶段——就是来一个请求,按顺序分给第一台、第二台、第三台服务器,平均分就行。错。
最早的负载均衡确实是这么干的,也就是行业里说的四层负载均衡:它根本读不懂你发的请求内容是什么,只看IP地址、端口号,按规则把流量甩过去就行。这种方式的问题在高并发场景下会被无限放大:比如你刚选完商品填好收货地址,点下”提交订单”的按钮,下一秒请求被路由到了另一台没存你登录会话的服务器上,直接给你踢回登录页,选了半小时的地址全没了,谁不发火?
后来才有了七层负载均衡,它能读懂HTTP、gRPC这类应用层的请求内容,甚至能根据请求头里的用户身份、设备类型、地理位置,甚至你之前的访问路径来选最合适的节点。我前几年帮一个做跨境直播的团队排查故障,他们用的还是最原始的轮询策略,结果住在东南亚的用户被分配到了部署在法兰克福的边缘节点,延迟直接飙到800ms,弹幕全是”卡成PPT”,运维还纳闷说我们带宽明明买够了啊?对吧,运维总觉得带宽够就万事大吉,根本没考虑路由策略对延迟的影响。
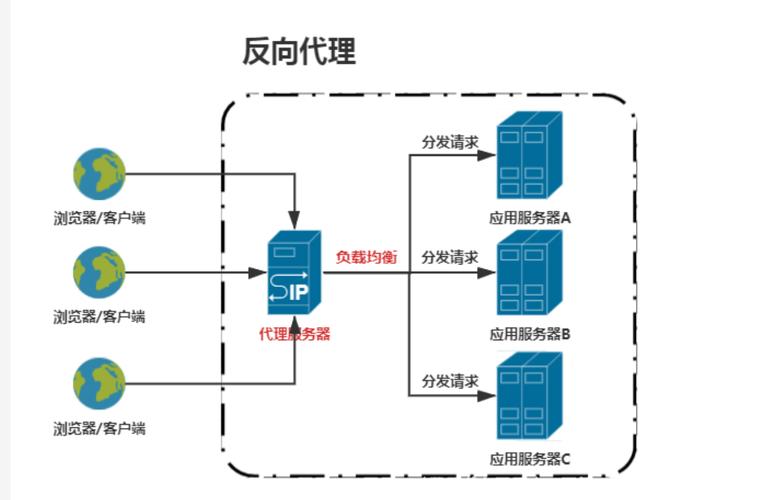
不过话说回来,就算有了七层的识别能力,负载均衡也不是万能的。它能做的只是把流量导到相对合适的节点上,但如果后端的数据库本身扛不住并发,就算把流量切得再均匀,整个系统还是会崩。这是很多人对负载均衡的另一个认知误区:把它当成了所有性能问题的解药,实际上它只是整个链路里的一个流量闸门,解决不了后端服务本身的瓶颈。
现在的负载均衡市场,早就不是F5一家说了算的时代了
倒回15年前,国内互联网公司要做负载均衡,基本只有两个选择:要么买F5的硬件盒子,一个盒子几十万,小公司根本用不起;要么自己用开源软件搭一套,稳定性全靠运维的经验堆。那时候F5的销售在行业里是横着走的,毕竟没人敢在核心流量入口上省这个钱。
云厂商把原来几十万的硬件盒子做成云上的按流量计费服务那天起,整个行业的游戏规则就变了。过去十年负载均衡产业最大的变量,不是技术迭代有多快,是整个交付逻辑从”卖硬件盒子”转向了”卖按使用量计费的云服务”。原来小公司要搭一套高可用的负载均衡系统,可能要花几十万买设备,还要专门招两个运维来维护,现在只要在云控制台点几下,按实际用的流量计费,一个月几十块钱就能拿到和大厂同等级的流量调度能力。
技术层面的迭代其实比大多数人感知的要快。前几年大家还在讨论怎么把七层转发的延迟降下来,现在很多大厂已经用上了eBPF技术,把流量转发的逻辑直接下沉到Linux内核里,根本不需要绕到用户态的应用程序,转发延迟能降到微秒级——要知道,原来的用户态转发,延迟基本都在毫秒级,差了整整三个数量级。
我去年参加一个云原生的行业闭门会,碰到一个原来在F5做了10年的销售,他说现在他们团队60%的单子,都是给原来的老客户做”云-端-边”的负载均衡统一纳管,纯卖硬件的单子占比已经不到20%了。毕竟谁都知道,现在的流量早就不是只待在数据中心里了,用户的请求会散落在全国各地的边缘节点、手机端的本地缓存、甚至家里的智能路由器上,没有哪一个硬件盒子能管住这么分散的流量。
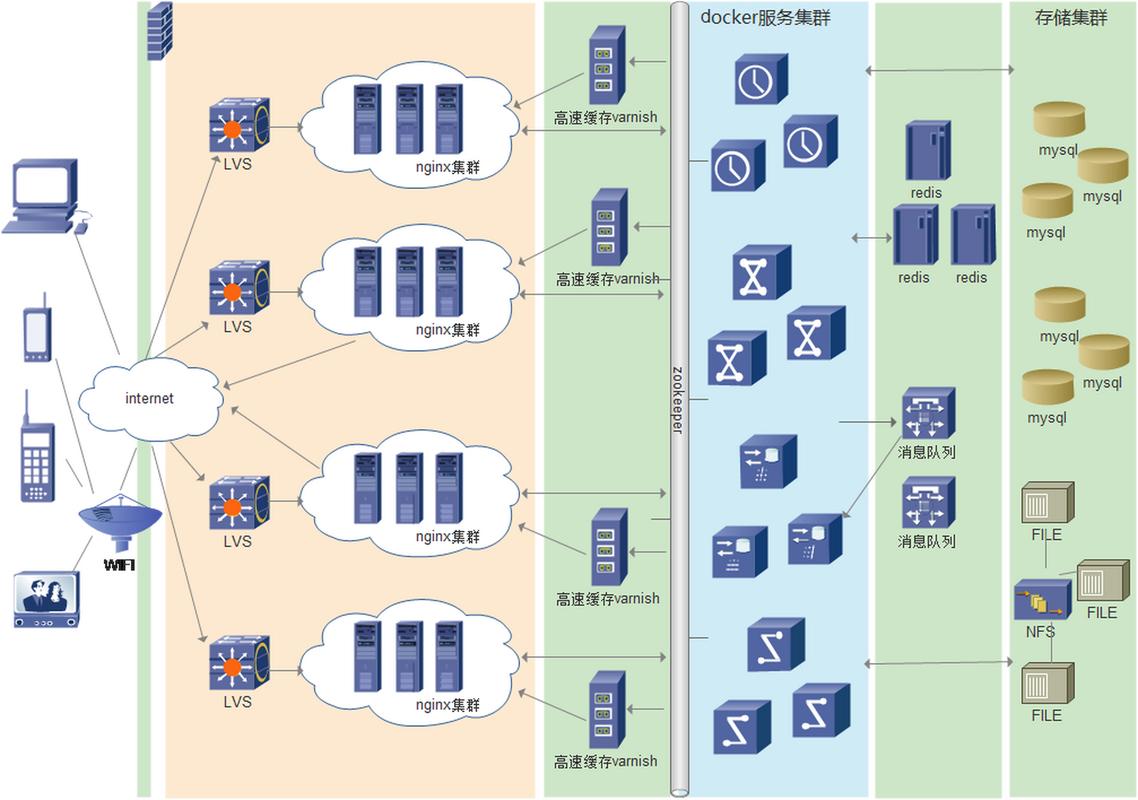
没人提的风险:负载均衡成了整个数字系统的”单点命门”
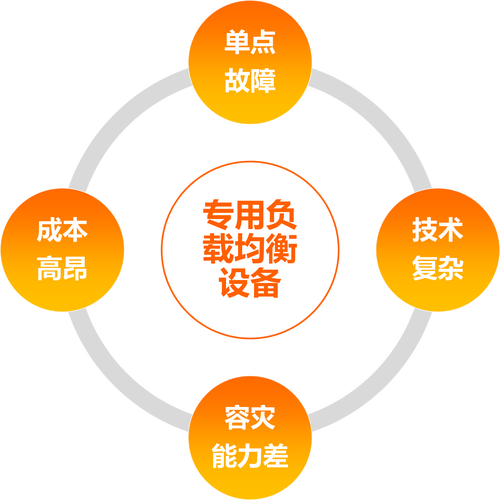
别觉得负载均衡是个跑了几十年的成熟技术,就不会出问题。恰恰相反,当所有的流量入口都收敛到这套系统上的时候,它已经变成了整个数字系统最脆弱的单点。
当所有的流量入口都收敛到负载均衡系统上的时候,这个系统的配置错误、漏洞、甚至被恶意攻击,都会直接传导到整个业务的最前端。我去年接触的一个本地生活平台,就是因为运维改负载均衡策略的时候,不小心把商家端的流量和用户端的流量混到了同一个资源池里,结果大中午饭点,用户端的请求直接把商家端的接口打挂,整整40分钟,商家没法接单,平台算下来赔了快200万的补贴。还有之前某公有云的负载均衡节点出了配置错误,导致整个华东区的很多互联网服务连续宕机2个小时,多少商家的预售流量直接断了,连个提前告警都没有。
说个没人愿意公开聊的细节:现在很多电商平台的负载均衡策略,已经开始和用户标签打通了——同样是刷商品详情页,年消费额超过10万的用户,会被优先分配到离他最近的、CPU占用率最低的边缘节点,页面打开速度可能是200ms,而新用户或者低消费用户,可能会被分配到负载已经80%的远端节点,打开速度是800ms。本质上这就是用负载均衡的能力,给不同的用户提供差异化的服务质量,说好听点是资源最优配置,说难听点,这就是藏在流量入口的隐形区别对待。
更麻烦的是,现在很多公司的负载均衡配置,还是靠运维手动敲命令,没有版本管理,没有灰度校验,改完配置直接全量生效。万一哪个参数写错了,根本没有回滚的机会。
未来3-5年的几个实在判断
首先,负载均衡不会再作为一个单独的产品存在。它会慢慢下沉到云操作系统、服务网格、边缘计算节点的底层,变成和水电一样的基础设施——你不会专门去买一个”负载均衡服务”,但你用的每一个云服务,背后都默认带了这套流量调度能力。
其次,所谓的”AI智能负载均衡”不会是大家吹的那种全自动化的黑盒系统,它的核心作用是做预测性调度:比如根据历史的流量波动规律,提前预判某个节点在未来10分钟可能会达到负载阈值,提前把一部分流量切走,而不是等CPU飙到99%的时候才被动切流。毕竟现在的流量波动越来越没有规律,大主播突然开播、热搜突然爆了,谁都没法靠固定的规则把所有情况覆盖到。
最后,合规的权重会越来越高。比如涉及到用户数据跨境的场景,负载均衡系统必须能把特定区域的流量,完全限制在对应的区域内,不能随便绕到境外的节点。这不是技术问题,是制度问题。
当然,这也意味着,谁掌握了负载均衡的调度权,谁就掌握了整个数字系统的流量入口。这个位置的权力,比很多人想象的要大得多。
作者|大讲堂
排版|大讲堂
审核|见微