 大讲堂

上周去苏州跑了三家工业视觉厂商,聊到最后发现个离谱的事——去年大家还在拼谁的模型接的云API多,今年会议室里挂的白板,全是边缘端的算力选型图。没人再提“全云化”的远期故事了。
先把边界划清楚:边缘智能根本不是“把小模型塞到硬件里”
很多人对边缘智能的理解还停留在字面,觉得就是把云端跑的大模型剪剪枝,塞到一个巴掌大的硬件盒子里就算完。这完全是误解。
从技术边界上讲,边缘智能的核心是把之前集中在核心云数据中心的推理计算(甚至小范围的增量训练),下沉到离数据产生源足够近的节点——这个节点可能是工厂车间里的工控机,可能是路口的路侧摄像头,可能是你家的智能空调,甚至是你口袋里的手机。
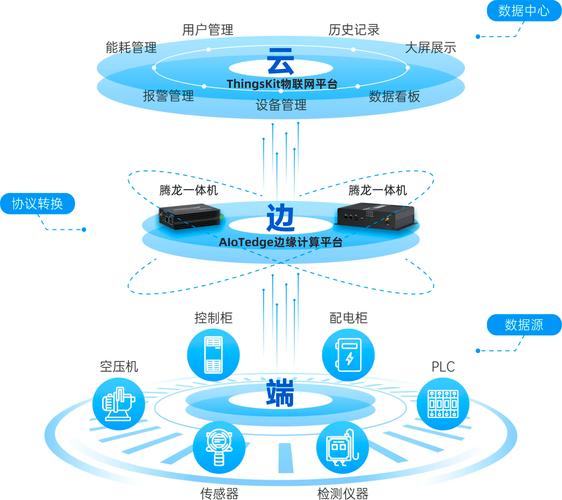
举个最直白的例子:之前你小区的人脸识别门禁,拍了你的脸要传到几百公里外的云服务器比对,网络抖一下,你站在门口举着脸跟个自动缴费机似的等两秒。现在的边缘智能方案,是把比对的算力直接放在门禁旁边的小盒子里,整个过程就在你站的那一米范围内完成,就算整栋楼断网,门禁照样能认人。
这不是什么新技术。只是之前整个行业都迷信“集中式算力的规模效应”,觉得把所有数据攒到一起训超大模型才是最优解,直到真金白银砸下去才发现,网络带宽成本、跨区域数据传输的合规风险、毫秒级延迟带来的体验损耗,早就把那点规模优势吃干净了。本质上,边缘智能不是云的“补充方案”,是整个算力架构的一次重新分配——把需要实时响应、涉及隐私敏感的计算留在离用户最近的地方,把需要海量数据、超大算力的模型训练留在云端,各干各的擅长事。
落地的真实现状:一半是跑通的硬生意,一半是自欺欺人的demo
我见过太多厂商吹自己的边缘智能方案,拉到现场一看,所谓的“边缘盒子”里跑的还是从云端同步过来的通用模型,连个针对场景的微调都没做,遇到车间里飘的铁屑、雨天摄像头的反光,识别准确率直接掉30个百分点。这种东西,说白了就是把云服务器的线拔了,假装自己在本地算,根本不算真的边缘智能。
现在能算硬突破的,其实就两个方向。一个是模型压缩的商业化成熟度真的上来了——之前要占几个G显存的工业视觉识别模型,经过结构化剪枝、量化压缩之后,能在单颗成本百来块的嵌入式芯片上跑,准确率的损耗不到2%,这在三年前是想都不敢想的事。另一个是边缘芯片的专用化,现在不管是国内的RISC-V架构芯片,还是海外的专门推理芯片,都针对边缘场景做了指令集优化,功耗比之前的通用CPU低一个数量级,直接把边缘节点的长期运维成本打下来了。
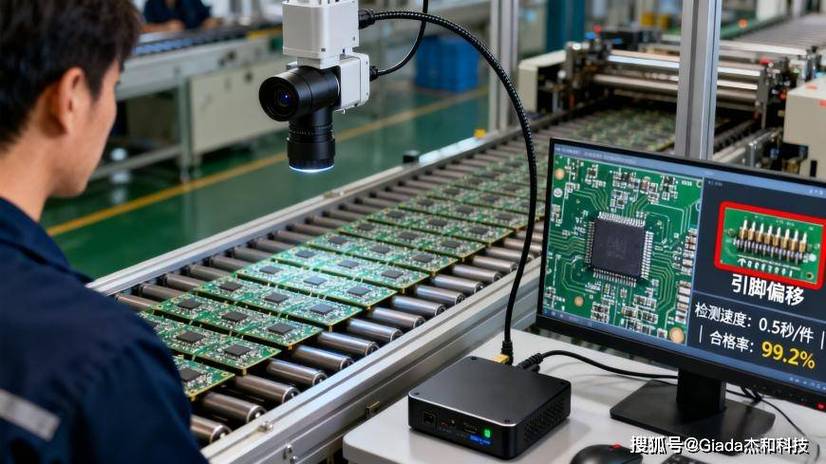
真正跑通的落地场景,基本都集中在对延迟、成本、合规有硬要求的领域。长三角的某汽车零部件工厂,之前用云端视觉检测方案,每拍一个零件就要传200M的高清原图,一年的带宽费就上百万,还经常因为产线离中心机房距离太远,检测延迟导致漏检。现在把边缘算力盒直接架在产线旁边,所有图像就在本地完成缺陷识别,只有检测到的异常样本才传到云端做统一的模型迭代,带宽成本直接砍了90%,漏检率反而降了40%。还有智能网联的路侧系统,之前所有路拍的视频都传到云端处理,现在边缘节点直接在路侧完成车辆识别、行人轨迹预测,给路口的红绿灯发动态调整信号,延迟从原来的200毫秒降到10毫秒以内——这才是自动驾驶能真的上路的基础,总不能等车快撞上了,云端的指令才慢悠悠传过来对吧。
被刻意回避的隐忧:边缘端的治理漏洞,比云端还难补
很多人说边缘智能安全,因为数据不出本地。扯淡。
首先是安全问题,边缘节点的数量太碎了。一个中型城市的公共摄像头可能有几十万个,每个都是一个独立的算力节点,你总不能像管云服务器那样,定期给每个节点打安全补丁、做权限巡检吧?之前就有过公开的案例,某城市的路边摄像头配套的边缘盒子,因为默认密码没改,被黑客入侵之后,直接把实时监控画面传到了境外的网站。
然后是伦理问题:之前用云端的时候,你至少还能拿“数据存储在合规的服务器集群,有严格的访问权限”当挡箭牌,现在边缘端的算力就在你家楼下、你公司的车间里,一个巴掌大的盒子里塞了什么模块、采了什么数据,普通用户根本看不见。谁能保证那个号称“本地处理人脸信息”的盒子,没被偷偷加了音频采集模块?
还有生态锁定的问题:现在各个厂商的边缘模型格式、硬件接口完全不通用,你买了A厂商的边缘盒子,就只能用A家的模型做迭代,想换B家的方案,整个硬件都得换掉。这哪里是技术落地,这是给客户埋新的长期绑定的陷阱。
我自己跑了快两年的产业调研,对接下来3-5年的趋势有三个很明确的判断:
第一,边缘端的推理算力总规模,会超过云端的通用推理算力规模。不是说云会消失,而是云会彻底退回到“模型训练中心”的定位,所有面向终端用户的、实时性要求高的推理需求,全都会下沉到边缘。现在所有厂商算的账都很清楚:每1TB的数据如果在本地边缘节点处理,成本是传到云端处理的1/10,没有理由放着便宜不占。
第二,会出现专门的“原生边缘模型”品类,再也不是现在这种把云端大模型剪剪枝扔到端上的残次品。这种模型从设计之初就针对边缘端的低功耗、小显存、碎片化场景做优化,参数可能只有云端大模型的1%,但是在特定工业、交通场景的准确率,比通用大模型还高。
第三,治理层面一定会出硬约束。比如未来会要求所有面向公共场景的边缘智能节点,必须有可追溯的硬件安全标识,不允许私自加装非合规的采集模块,不然这种散落在各个角落的算力节点,迟早会变成新的风险敞口。现在已经有几个工业发达的城市在做试点了,只是还没上升到全国性的统一标准。
说穿了,过去三年整个行业追着大模型跑,本质上是在找一个能包打天下的万能解药,但最后发现,产业要的从来不是什么站在聚光灯下的神,而是能实实在在解决问题的工具。边缘智能不是什么颠覆式的黑科技,它就是把算力放到离用户最近的地方,把成本降下来,把延迟压下去,把合规的风险兜住——这件事不性感,不适合在发布会上吹几个亿的市场规模,但才是真的能赚到钱的生意。
作者|大讲堂
排版|大讲堂
审核|白杨