2026-10-02 03:12:07 作者:大讲堂
上周约做AI算法的老周,在中关村开了十二年的茶记喝冰柠茶。他一坐下就把手机甩在桌上,屏幕亮着刚批下来的亿元算力预算单。十年前他蹲在这同一个位置跟我吐槽,说组里三块淘来的二手GPU,跑预训练跑了三个月,老板说他再瞎折腾就把工位撤了。
那时候整个圈子都觉得,预训练就是疯子才玩的东西。没人相信,无标注数据能喂出好用的AI
十年前做AI,逻辑简单得像搭积木。要做人脸识别,就得雇几百个人给几百万张脸标好姓名坐标;要做聊天机器人,就得攒几十万条标注好的问答对。所有训练都是对着特定任务来,一分钱一分货,多一点都是浪费。
老周那时候偏不。他拉着两个师弟,爬各种论坛爬了半年,攒了几个T的公开文本、图片,就是要跑一个预训练模型——说白了就是让AI先把这些五花八门的内容全啃一遍,先把人类说话的逻辑、万物的模样刻进参数里,之后再做任何任务,都不用从零开始。
 2012年AI实验室旧服务器机房
说实话那时候我都听不懂,只记得他说整个实验室只有他相信这个方向,申请经费被骂了三次,师弟熬了半年都转去做赚钱的自动驾驶项目了。他那时候叼着烟跟我说,大不了就去外面公司写业务码,反正这事儿他觉得能成。
谁能想到呢?也就五六年时间,整个行业都翻了个。
预训练变成了AI行业的沉默基建
现在你打开手机,输入法给你猜下一个字,短视频平台给你推你想看的内容,甚至你用AI生成一张海报,写一份方案,背后全是预训练好的大模型在撑着。
很多人只吹ChatGPT有多神奇,却没说透,ChatGPT的核心,就是用超大规模的数据做了超大规模的预训练。原来做AI的逻辑彻底变了:原来我们是给每个任务单独造一把锤子,现在我们用预训练造好了一整个巨型工具箱,你要拧螺丝还是敲钉子,拿出来改改就能用,成本砍到原来的十分之一都不到。
我去年认识一个开数据标注公司的老板,那几年他最高峰养了两千多标注员,这两年直接砍到两百人。他说现在做AI项目,甲方上来就说用预训练大模型调,根本不需要那么多标注数据,原来攒的标注生产线,现在半卖半送都没人要。
老周现在的实验室,光待机的GPU就能烧掉我一年工资。他跟我碰杯的时候笑,说当年老板骂他浪费电,现在老板反过来求他多开几个预训练项目,说抢不到赛道就晚了。
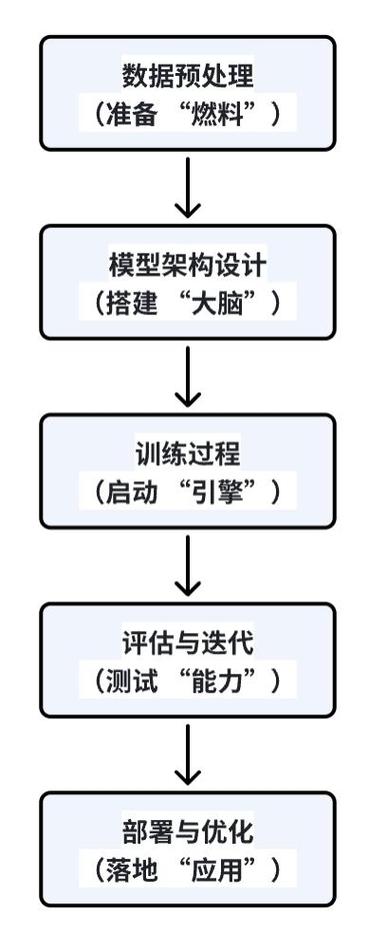 AI大模型预训练数据处理流程示意图
不过话说回来,预训练改变的从来不止AI行业,还有我们每个普通人的生活。
当我们的生活,开始被预训练框住
 当我们的生活,开始被预训练框住
你有没有过这种体验?就是你只是随口跟朋友提了一句想买运动鞋,打开手机所有APP的推荐全变成了运动鞋。你搜了一次抑郁症的科普,接下来半个月给你推的全是情绪负面的内容,甩都甩不开。
这背后,本质就是预训练的结果。预训练模型早已经把数十亿人的行为习惯、内容偏好全啃透了,它比你自己还懂你想要什么——或者说,它知道给你推什么,你才会点进去,才会停留。
它给你造了一个刚好符合你胃口的信息泡泡,你待在里面舒服得不想出来。时间长了,你都忘了泡泡外面是什么样子。
老周跟我讲过一件事,他去年招博士生,面试的时候让大家说一个自己想做的新方向,十个学生有八个说的方向,都是最近预训练领域发顶会多的热点,没有一个人提一个听起来有点异想天开的野路子。他说,现在学生找思路,都先去问大模型,大模型给的全是预训练里攒出来的成熟路径,没人愿意碰那些看起来没结果的东西了。
这挺让人唏嘘的。当年老周做预训练的时候,就是因为所有人都觉得这条路走不通,他才偷偷闷头搞,最后才等来了风来。现在所有人都挤在预训练铺好的大路上,还有人愿意去走没人走的小路吗?
昨天老周给我看了他十年前的笔记本,封皮都磨破了,里面写满了各种奇奇怪怪的思路,好多地方画着叉,写着“不对,跑不通”,但是字里行间全是不管不顾的劲。现在他的思路都存在云文档里,排版整齐,逻辑清晰,却很少再有那种红笔划出来的疯狂想法了。
预训练给了我们一个装满了人类所有过去经验的百宝箱,它让我们站在巨人的肩膀上,走得比原来快一百倍。可是,我们会不会,慢慢就忘了怎么自己去探索新的路?
冰柠茶的冰化了大半,老周擦了擦汗,拿起手机去接实验室的电话,说今天晚上新的预训练任务要开机了。窗外中关村的车水马龙,所有人都在往前跑,没人会停下来等这个问题的答案。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:预训练:我们的数字日常早已被它悄悄重构
文章链接:https://www.lfdjt.com/info_23_23538.html
 大讲堂
